<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://migue8gl.dev/feed.xml" rel="self" type="application/atom+xml" /><link href="https://migue8gl.dev/" rel="alternate" type="text/html" /><updated>2026-09-22T09:09:15+00:00</updated><id>https://migue8gl.dev/feed.xml</id><title type="html">Miguel García Blog</title><subtitle>¡Bienvenidos a mi blog! Aquí escribiré sobre cosas que me interesen.</subtitle><entry><title type="html">Privacidad en ML: Datos sintéticos (I)</title><link href="https://migue8gl.dev/2026/09/21/privacidad-en-ml-datos-sinteticos.html" rel="alternate" type="text/html" title="Privacidad en ML: Datos sintéticos (I)" /><published>2026-09-21T00:00:00+00:00</published><updated>2026-09-21T00:00:00+00:00</updated><id>https://migue8gl.dev/2026/09/21/privacidad-en-ml-datos-sinteticos</id><content type="html" xml:base="https://migue8gl.dev/2026/09/21/privacidad-en-ml-datos-sinteticos.html"><![CDATA[<h2 id="privacidad-y-seguridad">Privacidad y seguridad</h2>
<p>Este artículo va a ser el primero de una mini serie, donde voy a explicar y a programar sencillos <em>scripts</em> en <em>Python</em> para entender cómo funciona este mundo de la privacidad en el <em>machine learning</em>. Es un tema que, si os soy sincero, no sabía que existía hace un año. Lo descubrí mientras investigaba artículos de referencia para mi trabajo de fin de máster (estudio de métodos <a href="/2026/04/24/sabe-una-red-neuronal-lo-que-no-sabe">OOD</a>). En concreto, estaba buscando algún método que fuese capaz de mejorar el <em>prior</em> en que se basan los modelos <strong>VAE</strong> (<em>Variational Autoencoders</em>), y de esa forma, poder mejorar el espacio latente para detectar mejor los datos fuera de distribución. Sé que suena a chino, ya explicaré mejor en qué consisten los <em>VAE</em>. El caso es que encontré este <a href="https://arxiv.org/abs/2404.08434">paper</a>, que poco tiene que ver con detección. Aquí fue cuando conocí este nicho que es la privacidad en <em>machine learning</em> (a partir de ahora lo acortaré a <em>ML</em>).</p>

<p>A grandes rasgos, existen métodos por los cuales es posible extraer datos sensibles de un modelo. No solo eso, también se puede “envenenar” ese modelo de forma que deteriore sus predicciones. La cantidad de tipos de ataques que se pueden realizar es bastante amplia, por ello, lo trataré en otros capítulos de esta mini serie.</p>

<h2 id="datos-sintéticos">Datos sintéticos</h2>
<p>Seguramente hayáis oído hablar de <strong>datos sintéticos</strong> en el ámbito de la <em>IA</em> moderna. Simulaciones de conversaciones con <em>ChatGPT</em>, imágenes generadas con algún modelo de difusión, simulaciones de entornos de conducción, etc. Todo ello con la finalidad de suplir la necesidad voraz de datos que hoy en día acucia a las grandes empresas de <em>IA</em>. Pues vamos a hacer algo parecido pero a menor escala, con datos tabulares, algo más cutre.</p>

<p>Antes he mencionado ataques capaces de extraer datos sensibles de usuarios a partir de un modelo de <em>ML</em>. El cómo es tema de un futuro capítulo, el porqué es obvio, a día de hoy cualquier dato de cualquier persona en conjunto con algo más de información sirve a muchos delincuentes muy creativos para poder desarrollar ataques y estafas cada vez más enrevesados y eficaces. Imaginemos un modelo entrenado para detectar enfermedades a partir de historiales médicos. Un atacante podría utilizar determinadas técnicas para intentar averiguar qué información ha visto el modelo durante su entrenamiento o, incluso, si los datos de una persona concreta formaron tiene ciertas características. Esto último puede parecer una información menor, pero pensemos en un modelo entrenado exclusivamente con pacientes que padecen una determinada enfermedad. Si conseguimos demostrar que los datos de una persona concreta fueron utilizados para entrenarlo, acabamos de obtener una pista bastante clara sobre su estado de salud, sin necesidad de acceder directamente a su historial médico.</p>

<p>La solución más evidente es la de entrenar con datos sintéticos, datos de personas ficticias, pero que mantengan una distribución y cierto tipo de información similar a los datos originales. La creación de este tipo de dato <em>no es cosa menor, dicho de otra manera, es cosa mayor</em> ~ <a href="https://www.youtube.com/watch?v=o5TWcntqixw">Rajoy</a>. Para generar datos sintéticos de calidad se necesitan los datos originales y métodos suficientemente refinados. Es una constante lucha entre mejorar la calidad y no desvelar información de los datos originales, porque prácticamente no existe ningún método que sea totalmente infalible. Mejorar una métrica, seguramente empeore otra y por tanto hay que encontrar un equilibrio.</p>

<p>Hoy voy a explicar algunos de los métodos más sencillos para medir la calidad de los datos sintéticos. Uno para medir si los datos son robustos frente a un tipo de ataque concreto y otro para evaluar la similitud con los datos reales. A medida que avance esta serie, iré incorporando otros más elaborados usando métricas específicas y métodos avanzados.</p>

<h3 id="generación-de-datos-sintéticos-con-un-cvae">Generación de datos sintéticos con un CVAE</h3>
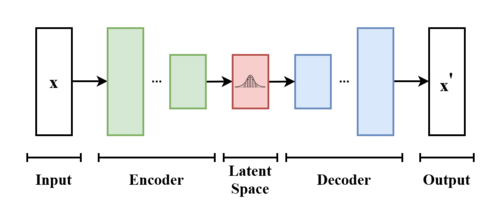
<p>Los ya mencionados <em>Variational Autoencoders</em> son un tipo de red neuronal capaz de aprender la distribución de los datos y utilizarla para generar nuevas muestras. A diferencia de un <em>autoencoder</em> tradicional, que transforma cada entrada $x$ en un único vector latente $z$, un <em>VAE</em> aprende una distribución:</p>

\[q_\phi(z|x) = \mathcal{L}(\mu_\phi(x), \sigma_\phi(x)^2)\]

<p>De esta distribución se muestrea $z$, que posteriormente utiliza el decoder para reconstruir el dato:</p>

\[z = \mu + \sigma\epsilon, \qquad \epsilon \sim \mathcal{N}(0,I)\]

<p>Durante el entrenamiento se busca que el dato reconstruido sea similar al original y, al mismo tiempo, que las distribuciones latentes se parezcan a una distribución normal. Por ello, la función de pérdida combina un término de reconstrucción (que los datos se parezcan a los originales) con la divergencia <em>KL</em> (digamos que es como una “"”distancia””” entre distribuciones):</p>

\[\mathcal{L} = \mathcal{L}{reconstrucción} + D{KL}(q_\phi(z|x),||,p(z))\]

<p>Esta regularización hace que el espacio latente sea más continuo y permite muestrear nuevos puntos para generar datos. Aunque los modelos generativos actuales son mucho más complejos, los <em>VAE</em> siguen utilizándose como componentes de arquitecturas más grandes.</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/privacidad-en-ml-datos-sinteticos/vae.png" alt="Estructura de un VAE." width="500" class="center" />
  <figcaption class="center">Estructura de un VAE.</figcaption>
</figure>

<p>Con un modelo de este tipo, podríamos muestrear el espacio latente aprendido de forma aleatoria y reconstruir esas muestras. No son datos reales, pero deberían conservar características similares. Estos son nuestros datos sintéticos. Pero hay un problema. Si queremos usarlos para predecir algo, ¿cómo sabemos qué predecimos? Es decir, tenemos datos muy parecidos a los reales, pero no sabemos <strong>qué</strong> son. En en el conjunto original teníamos algún tipo de información extra, por ejemplo, si quisiéramos clasificar pacientes (tiene cáncer o no tiene cáncer), o clientes (de riesgo o seguros), deberíamos tener una etiqueta para poder entrenar un modelo de clasificación binario. Eso el <em>VAE</em> no lo ha aprendido y por tanto, solo tenemos un batiburrillo de puntos en el espacio.</p>

<p>Por fortuna, existe una variación capaz de aprender no solo la distribución de los datos, sino también la clase de estos. Los <em>Conditional Variational Autoencoders</em> o <strong>CVAE</strong> entienden también qué tipo de datos queremos generar. A partir de ahora vamos a trabajar con el conjunto de <strong>Iris</strong>, por lo que pongamos un ejemplo:</p>

<table>
  <thead>
    <tr>
      <th style="text-align: center">Largo sépalo</th>
      <th style="text-align: center">Ancho sépalo</th>
      <th style="text-align: center">Largo pétalo</th>
      <th style="text-align: center">Ancho pétalo</th>
      <th style="text-align: center">Clase</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: center">5.1</td>
      <td style="text-align: center">3.5</td>
      <td style="text-align: center">1.4</td>
      <td style="text-align: center">0.2</td>
      <td style="text-align: center"><em>setosa</em></td>
    </tr>
    <tr>
      <td style="text-align: center">4.9</td>
      <td style="text-align: center">3.0</td>
      <td style="text-align: center">1.4</td>
      <td style="text-align: center">0.2</td>
      <td style="text-align: center"><em>setosa</em></td>
    </tr>
    <tr>
      <td style="text-align: center">6.4</td>
      <td style="text-align: center">3.2</td>
      <td style="text-align: center">4.5</td>
      <td style="text-align: center">1.5</td>
      <td style="text-align: center"><em>versicolor</em></td>
    </tr>
    <tr>
      <td style="text-align: center">5.9</td>
      <td style="text-align: center">3.0</td>
      <td style="text-align: center">4.2</td>
      <td style="text-align: center">1.5</td>
      <td style="text-align: center"><em>versicolor</em></td>
    </tr>
    <tr>
      <td style="text-align: center">6.3</td>
      <td style="text-align: center">3.3</td>
      <td style="text-align: center">6.0</td>
      <td style="text-align: center">2.5</td>
      <td style="text-align: center"><em>virginica</em></td>
    </tr>
    <tr>
      <td style="text-align: center">5.8</td>
      <td style="text-align: center">2.7</td>
      <td style="text-align: center">5.1</td>
      <td style="text-align: center">1.9</td>
      <td style="text-align: center"><em>virginica</em></td>
    </tr>
  </tbody>
</table>

<p>Cada flor está descrita por cuatro características numéricas y pertenece a una de tres clases. El <strong>CVAE</strong> puede aprender la distribución de estas características <strong>condicionada a la clase</strong>. Es decir, en lugar de aprender únicamente $p(x)$, buscamos aprender algo como:</p>

\[p(x|c)\]

<p>donde $x$ representa las características de la flor y $c$ su clase.</p>

<p>Para que la red pueda utilizar esta información, primero transformamos la clase mediante <strong>one-hot encoding</strong>. Por ejemplo:</p>

\[\text{setosa} = [1,0,0]\]

\[\text{versicolor} = [0,1,0]\]

\[\text{virginica} = [0,0,1]\]

<p>Esta representación se introduce en el encoder junto con las características de la flor. De esta forma, el encoder no recibe únicamente $x$, sino también la clase $c$:</p>

\[q_\phi(z|x,c)\]

<p>El decoder recibe igualmente esta información para generar una muestra perteneciente a la clase indicada:</p>

\[p_\theta(x|z,c)\]

<p>Por ejemplo, podríamos proporcionar al decoder un vector latente $z$ y la condición $c=[0,0,1]$. El modelo intentará generar entonces las características de una flor <em>virginica</em>. Así podemos generar nuevas muestras no solo parecidas a los datos originales, sino pertenecientes a la clase que nosotros indiquemos.</p>

<p>El código del <em>CVAE</em> es el siguiente:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">CVAE</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span>
        <span class="bp">self</span><span class="p">,</span>
        <span class="n">input_dim</span><span class="p">:</span> <span class="nb">int</span><span class="p">,</span>
        <span class="n">hidden_dim</span><span class="p">:</span> <span class="nb">int</span><span class="p">,</span>
        <span class="n">latent_dim</span><span class="p">:</span> <span class="nb">int</span><span class="p">,</span>
        <span class="n">num_classes</span><span class="p">:</span> <span class="nb">int</span><span class="p">,</span>
    <span class="p">):</span>
        <span class="nb">super</span><span class="p">().</span><span class="n">__init__</span><span class="p">()</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">encoder</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="n">Sequential</span><span class="p">(</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">Linear</span><span class="p">(</span><span class="n">in_features</span><span class="o">=</span><span class="n">input_dim</span> <span class="o">+</span> <span class="n">num_classes</span><span class="p">,</span> <span class="n">out_features</span><span class="o">=</span><span class="n">hidden_dim</span><span class="p">),</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">ReLU</span><span class="p">(),</span>
        <span class="p">)</span>

        <span class="bp">self</span><span class="p">.</span><span class="n">mu</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="n">Linear</span><span class="p">(</span><span class="n">in_features</span><span class="o">=</span><span class="n">hidden_dim</span><span class="p">,</span> <span class="n">out_features</span><span class="o">=</span><span class="n">latent_dim</span><span class="p">)</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">logvar</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="n">Linear</span><span class="p">(</span><span class="n">in_features</span><span class="o">=</span><span class="n">hidden_dim</span><span class="p">,</span> <span class="n">out_features</span><span class="o">=</span><span class="n">latent_dim</span><span class="p">)</span>

        <span class="bp">self</span><span class="p">.</span><span class="n">decoder</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="n">Sequential</span><span class="p">(</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">Linear</span><span class="p">(</span><span class="n">in_features</span><span class="o">=</span><span class="n">latent_dim</span> <span class="o">+</span> <span class="n">num_classes</span><span class="p">,</span> <span class="n">out_features</span><span class="o">=</span><span class="n">hidden_dim</span><span class="p">),</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">ReLU</span><span class="p">(),</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">Linear</span><span class="p">(</span><span class="n">in_features</span><span class="o">=</span><span class="n">hidden_dim</span><span class="p">,</span> <span class="n">out_features</span><span class="o">=</span><span class="n">input_dim</span><span class="p">),</span>
        <span class="p">)</span>

    <span class="k">def</span> <span class="nf">encode</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">x</span><span class="p">:</span> <span class="n">Tensor</span><span class="p">,</span> <span class="n">y</span><span class="p">:</span> <span class="n">Tensor</span><span class="p">):</span>
        <span class="n">h</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">encoder</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="n">cat</span><span class="p">([</span><span class="n">x</span><span class="p">,</span> <span class="n">y</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">))</span>
        <span class="k">return</span> <span class="bp">self</span><span class="p">.</span><span class="n">mu</span><span class="p">(</span><span class="n">h</span><span class="p">),</span> <span class="bp">self</span><span class="p">.</span><span class="n">logvar</span><span class="p">(</span><span class="n">h</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">decode</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">z</span><span class="p">:</span> <span class="n">Tensor</span><span class="p">,</span> <span class="n">y</span><span class="p">:</span> <span class="n">Tensor</span><span class="p">):</span>
        <span class="k">return</span> <span class="bp">self</span><span class="p">.</span><span class="n">decoder</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="n">cat</span><span class="p">([</span><span class="n">z</span><span class="p">,</span> <span class="n">y</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">))</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">x</span><span class="p">:</span> <span class="n">Tensor</span><span class="p">,</span> <span class="n">y</span><span class="p">:</span> <span class="n">Tensor</span><span class="p">):</span>
        <span class="n">mu</span><span class="p">,</span> <span class="n">logvar</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">encode</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">y</span><span class="p">)</span>

        <span class="n">std</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">exp</span><span class="p">(</span><span class="mf">0.5</span> <span class="o">*</span> <span class="n">logvar</span><span class="p">)</span>
        <span class="n">z</span> <span class="o">=</span> <span class="n">mu</span> <span class="o">+</span> <span class="n">std</span> <span class="o">*</span> <span class="n">torch</span><span class="p">.</span><span class="n">randn_like</span><span class="p">(</span><span class="n">std</span><span class="p">)</span>

        <span class="n">x_hat</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">decode</span><span class="p">(</span><span class="n">z</span><span class="p">,</span> <span class="n">y</span><span class="p">)</span>

        <span class="k">return</span> <span class="n">x_hat</span><span class="p">,</span> <span class="n">mu</span><span class="p">,</span> <span class="n">logvar</span>
</code></pre></div></div>

<p>Para generar muestras sintéticas solo necesitamos el decoder. Muestreamos aleatoriamente un vector $z$ del espacio latente siguiendo una distribución <em>gaussiana</em> y lo pasamos al decoder junto con la clase que queremos generar. El decoder transforma este vector en una nueva muestra con las características correspondientes a dicha clase:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">generate_synthetic_sample</span><span class="p">(</span>
    <span class="n">model</span><span class="p">:</span> <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">,</span>
    <span class="n">sample_size</span><span class="p">:</span> <span class="nb">int</span><span class="p">,</span>
    <span class="n">latent_dim</span><span class="p">:</span> <span class="nb">int</span><span class="p">,</span>
    <span class="n">num_classes</span><span class="p">:</span> <span class="nb">int</span><span class="p">,</span>
<span class="p">)</span> <span class="o">-&gt;</span> <span class="nb">tuple</span><span class="p">[</span><span class="n">torch</span><span class="p">.</span><span class="n">Tensor</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="n">Tensor</span><span class="p">]:</span>
    <span class="n">size</span> <span class="o">=</span> <span class="n">sample_size</span> <span class="o">//</span> <span class="n">num_classes</span>
    <span class="n">samples</span> <span class="o">=</span> <span class="p">[]</span>
    <span class="n">sample_labels</span> <span class="o">=</span> <span class="p">[]</span>

    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="n">inference_mode</span><span class="p">():</span>
        <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">num_classes</span><span class="p">):</span>
            <span class="n">z</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">randn</span><span class="p">(</span><span class="n">size</span><span class="p">,</span> <span class="n">latent_dim</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">DEVICE</span><span class="p">)</span>
            <span class="n">labels</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">full</span><span class="p">((</span><span class="n">size</span><span class="p">,),</span> <span class="n">i</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">long</span><span class="p">,</span> <span class="n">device</span><span class="o">=</span><span class="n">DEVICE</span><span class="p">)</span>
            <span class="n">y</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="n">one_hot</span><span class="p">(</span><span class="n">labels</span><span class="p">,</span> <span class="n">num_classes</span><span class="o">=</span><span class="n">num_classes</span><span class="p">).</span><span class="nb">float</span><span class="p">()</span>

            <span class="n">X_synth</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="n">decode</span><span class="p">(</span><span class="n">z</span><span class="p">,</span> <span class="n">y</span><span class="p">)</span>
            <span class="n">samples</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">X_synth</span><span class="p">)</span>
            <span class="n">sample_labels</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">labels</span><span class="p">)</span>

    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="n">cat</span><span class="p">(</span><span class="n">samples</span><span class="p">),</span> <span class="n">torch</span><span class="p">.</span><span class="n">cat</span><span class="p">(</span><span class="n">sample_labels</span><span class="p">)</span>
</code></pre></div></div>

<!-- _includes/image_grid.html -->
<figure class="image-grid">
  <div class="image-row">
    
    
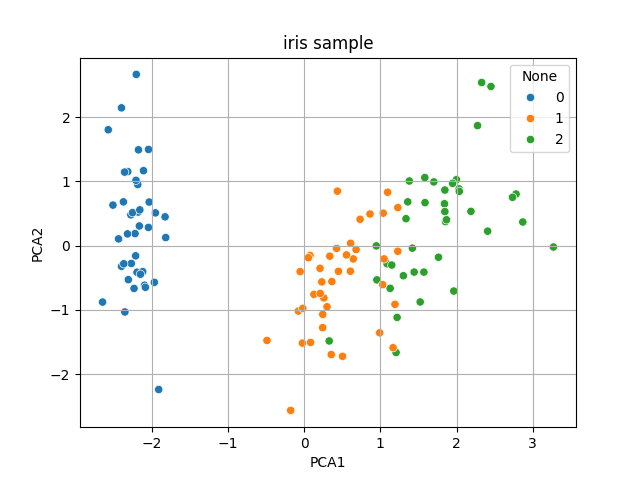
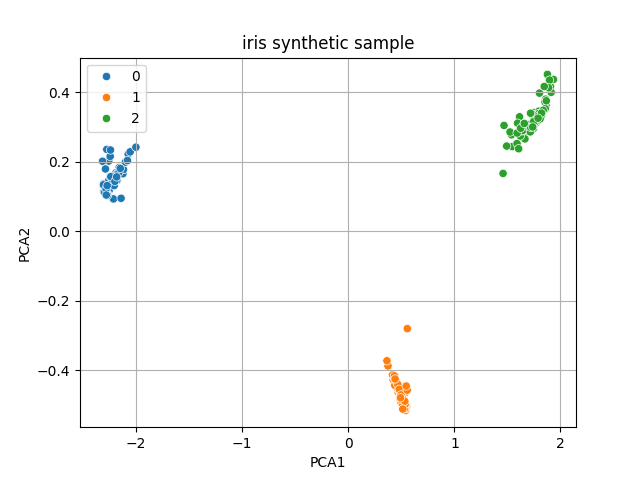
      <img src="/assets/images/privacidad-en-ml-datos-sinteticos/iris_sample.png" alt="Datos en el plano dadas sus componentes principales para su visualización. A la izquierda muestra real y la derecha muestra generada por el CVAE." class="grid-image" />


      <img src="/assets/images/privacidad-en-ml-datos-sinteticos/iris_synthetic_sample.png" alt="Datos en el plano dadas sus componentes principales para su visualización. A la izquierda muestra real y la derecha muestra generada por el CVAE." class="grid-image" />


  </div>
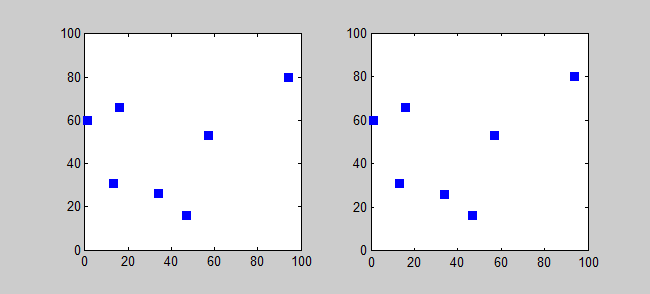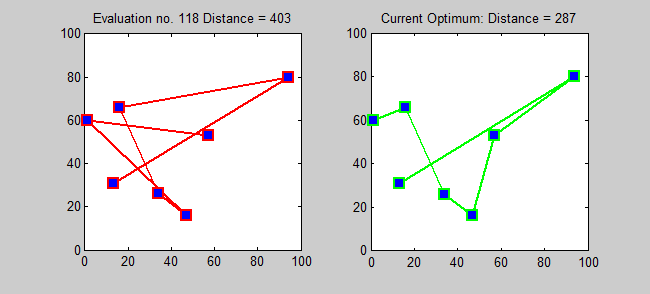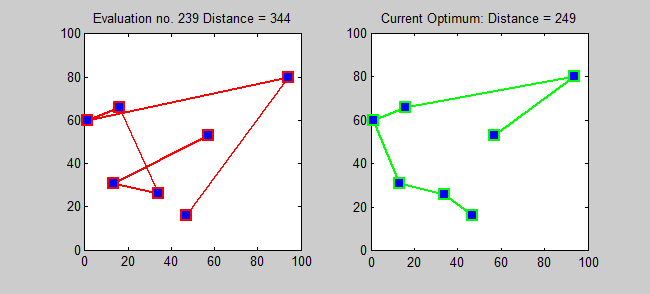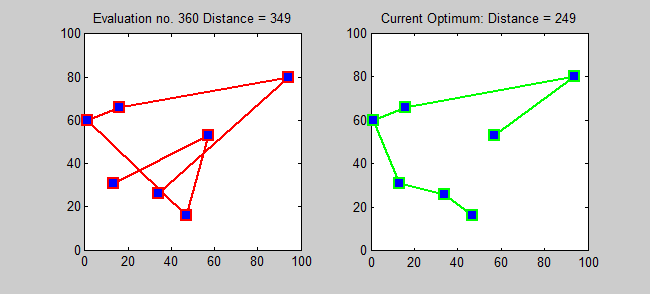
  <figcaption class="center">Datos en el plano dadas sus componentes principales para su visualización. A la izquierda muestra real y la derecha muestra generada por el CVAE.</figcaption>
</figure>

<h3 id="evaluación-por-potencia-predictiva">Evaluación por potencia predictiva</h3>
<p>Ahora ya tenemos un modelo capaz de generar datos de Iris de forma infinita, generar flores ficticias que nunca han sido registradas porque no existen. Pero, ¿realmente sirven estos datos artificiales para nuestro propósito de entrenar un predictor de especies de flores? Quiero recordar que los hemos generado con un propósito. Vamos a usarlos en vez de los originales, vaya a ser que un <em>hacker</em> del <em>ML</em> filtre importantísima información privada de las flores. En estos casos, existe un protocolo llamado <strong>train synthetic, test real</strong>. Vamos a ponerlo en práctica. Usaremos los datos sintéticos para entrenar un clasificador cualquiera, y si de verdad son buenos, cuando evaluemos el modelo en un conjunto de test <strong>real</strong> con datos que nunca ha visto, debería tener un buen rendimiento.</p>

<p>El protocolo es el siguiente: entrenamos dos modelos, uno con los datos de entrenamiento originales y otro con los datos sintéticos. Después, evaluamos ambos modelos sobre el mismo conjunto de test real. En este caso he probado con un modelo basado en <em>logistic regression</em> de <em>scikit-learn</em>, uno de los más básicos.</p>

<p>Además, vamos a utilizar una técnica llamada <strong>bootstrapping</strong> para estimar la variabilidad de los resultados. En lugar de quedarnos con una única medida de rendimiento, como el <em>accuracy</em> obtenido sobre el conjunto de test, generamos muchas muestras mediante muestreo con reemplazo (es decir, mismos valores pueden repetirse en el muestreo) a partir de los datos de test. Evaluamos el modelo sobre cada una de estas muestras y obtenemos así una distribución de los resultados.</p>

<p>Esto nos permite estimar un <strong>intervalo de confianza</strong> para las métricas y comprobar hasta qué punto las diferencias entre el modelo entrenado con datos reales y el entrenado con datos sintéticos son estables o pueden deberse a la variabilidad de la muestra de test.</p>

<p>La base estadística del método es que, bajo condiciones bastante generales, la distribución empírica obtenida mediante estas muestras con reemplazo proporciona una buena aproximación a la distribución muestral real que obtendríamos si pudiéramos repetir el experimento muchas veces. Por eso el <em>bootstrap</em> resulta especialmente útil cuando no conocemos o no queremos asumir una distribución paramétrica.</p>

<p>Para el público general $\rightarrow$ “Si pudiera repetir este experimento muchas veces con distintos conjuntos de test extraídos de la misma población, ¿cuánto cambiaría mi resultado?”</p>

<p>Los resultados son los siguientes:</p>

<table>
  <thead>
    <tr>
      <th style="text-align: center">Métrica</th>
      <th style="text-align: center">R→R</th>
      <th style="text-align: center">S→R</th>
      <th style="text-align: center">Δ</th>
      <th style="text-align: center">IC 95%</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: center">Accuracy</td>
      <td style="text-align: center">0.9333</td>
      <td style="text-align: center">0.8333</td>
      <td style="text-align: center">−0.0986</td>
      <td style="text-align: center">[−0.2000, 0.0000]</td>
    </tr>
    <tr>
      <td style="text-align: center">F1 Macro</td>
      <td style="text-align: center">0.9333</td>
      <td style="text-align: center">0.8295</td>
      <td style="text-align: center">−0.1068</td>
      <td style="text-align: center">[−0.2306, 0.0000]</td>
    </tr>
    <tr>
      <td style="text-align: center">F1 Weighted</td>
      <td style="text-align: center">0.9333</td>
      <td style="text-align: center">0.8295</td>
      <td style="text-align: center">−0.1031</td>
      <td style="text-align: center">[−0.2262, 0.0000]</td>
    </tr>
  </tbody>
</table>

<p>Como era de esperar, el clasificador entrenado con datos reales rinde mejor que el entrenado con sintéticos. En <em>accuracy</em> pasamos de $0.933$ a $0.833$. Aun así, el resultado del entrenamiento con los datos vomitados por el <em>CVAE</em> no  es despreciable, ya que con una arquitectura muy simple y sin ajustar hiperparámetros, acierta $5$ de cada $6$ flores reales.</p>

<p>El <em>bootstrapping</em> apunta en la misma dirección. La diferencia ($\Delta S-R$) es negativa en las tres métricas, con <em>IC</em> al $95\%$ de aproximadamente $[-0.2, 0]$. Pero como el extremo superior toca el cero (los resultados son como mucho, iguales, y por ello la diferencia es cero), la evidencia es débil y no podemos descartar que la diferencia sea nula. Mejorar la arquitectura y los hiperparámetros probablemente reduzca la brecha.</p>

<h3 id="los-datos-sintéticos-son-realmente-buenos">¿Los datos sintéticos son realmente buenos?</h3>
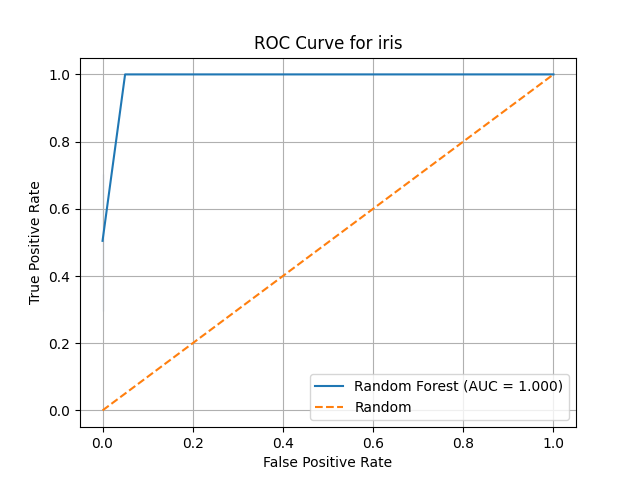
<p>Cuando queremos saber si los datos sintéticos son buenos, tenemos un amplio abanico de metodologías que nos proporcionan métricas muy interesantes para analizar. En este caso, vamos a probar con <strong>resemblance</strong> para ver lo buenos que son en similitud. Se trata de intentar distinguir si un dato es sintético o real, por lo que es una clasificación binaria. Para ello he utilizado un <em>random forest</em> como discriminador y he etiquetado cada muestra.</p>

<table>
  <thead>
    <tr>
      <th style="text-align: center"> </th>
      <th style="text-align: center">precision</th>
      <th style="text-align: center">recall</th>
      <th style="text-align: center">f1-score</th>
      <th style="text-align: center">support</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: center"><strong>0.0</strong></td>
      <td style="text-align: center">1.00</td>
      <td style="text-align: center">1.00</td>
      <td style="text-align: center">1.00</td>
      <td style="text-align: center">40</td>
    </tr>
    <tr>
      <td style="text-align: center"><strong>1.0</strong></td>
      <td style="text-align: center">1.00</td>
      <td style="text-align: center">1.00</td>
      <td style="text-align: center">1.00</td>
      <td style="text-align: center">24</td>
    </tr>
    <tr>
      <td style="text-align: center"><strong>accuracy</strong></td>
      <td style="text-align: center">—</td>
      <td style="text-align: center">—</td>
      <td style="text-align: center">1.00</td>
      <td style="text-align: center">64</td>
    </tr>
    <tr>
      <td style="text-align: center"><strong>macro avg</strong></td>
      <td style="text-align: center">1.00</td>
      <td style="text-align: center">1.00</td>
      <td style="text-align: center">1.00</td>
      <td style="text-align: center">64</td>
    </tr>
    <tr>
      <td style="text-align: center"><strong>weighted avg</strong></td>
      <td style="text-align: center">1.00</td>
      <td style="text-align: center">1.00</td>
      <td style="text-align: center">1.00</td>
      <td style="text-align: center">64</td>
    </tr>
  </tbody>
</table>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/privacidad-en-ml-datos-sinteticos/iris_roc_curve.png" alt="Curva ROC para RF Resemblance" width="500" class="center" />
  <figcaption class="center">Curva ROC para RF Resemblance</figcaption>
</figure>

<p>Los resultados son… ¡Una mierda! El discriminador es capaz de distinguir perfectamente entre los datos reales y los sintéticos. Desde el punto de vista de <em>resemblance</em>, esto indica que ambos conjuntos presentan diferencias claras que el <em>random forest</em> puede aprovechar para clasificarlos. De hecho, mirando las agrupaciones generadas en las imágenes anteriores, visualmente es bastante perceptible.</p>

<p>Sin embargo, este resultado no significa por sí mismo que los datos sintéticos sean inútiles ni que tengan una mala privacidad. <em>Resemblance</em> mide hasta qué punto los datos sintéticos se parecen a los reales, pero no mide directamente si existe riesgo de revelar información sobre los individuos utilizados durante el entrenamiento.</p>

<p>Que los datos sintéticos sean suficientemente útiles como para entrenar otro modelo no significa necesariamente que reproduzcan fielmente la distribución de los datos reales. Del mismo modo, conseguir que sean muy parecidos a los datos originales tampoco garantizaría que sean privados. Utilidad, similitud y privacidad son propiedades relacionadas, pero diferentes, y será necesario evaluarlas por separado.</p>

<h3 id="y-qué-pasa-con-la-privacidad">¿Y qué pasa con la privacidad?</h3>

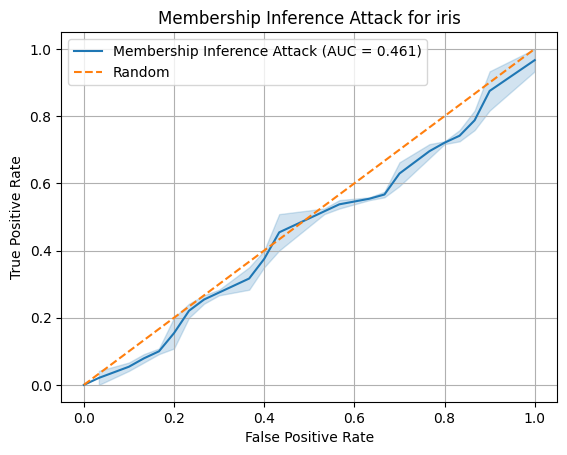
<p>Para evaluar la privacidad necesitamos comprobar algo distinto, como por ejemplo, si es posible averiguar qué registros reales fueron utilizados para entrenar el <em>CVAE</em>. Para ello, realizamos un <strong>Membership Inference Attack</strong>, comparando los registros del conjunto de entrenamiento con los del conjunto de test. Para cada registro calculamos su distancia al dato sintético más cercano y utilizamos esta distancia como señal para intentar distinguir entre ambos grupos. Si el <em>CVAE</em> hubiera memorizado registros de entrenamiento, estos podrían quedar más cerca de los datos sintéticos generados que los registros que nunca vio.</p>

<p>La capacidad del ataque se mide mediante <em>ROC-AUC</em>, donde un valor cercano a $0.5$ indica que el ataque no consigue distinguirlos. En este experimento obtenemos un <em>score</em> de $0.461$, ¡buenas noticias por fin!</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/privacidad-en-ml-datos-sinteticos/iris_membership_inference.png" alt="Curva ROC para Membership Inference Attack" width="500" class="center" />
  <figcaption class="center">Curva ROC para Membership Inference Attack</figcaption>
</figure>

<p>Esto, de nuevo, no significa que el <em>CVAE</em> sea completamente privado, sino únicamente que este ataque concreto no consigue extraer una señal clara de <em>membership</em>. Precisamente por eso, en los siguientes artículos veremos ataques y métricas más sofisticados para estudiar hasta qué punto los datos sintéticos pueden proteger realmente la información utilizada durante el entrenamiento y qué otras formas hay de generarlos.</p>]]></content><author><name></name></author><category term="ia" /><category term="ml" /><category term="inteligencia artificial" /><category term="privacy" /><category term="privacidad" /><category term="seguridad" /><category term="cvae" /><category term="datos sintéticos" /><category term="synthetic" /><category term="augmentation" /><category term="resemblance" /><summary type="html"><![CDATA[La privacidad y seguridad en el Machine Learning es un tema poco hablado, aunque sí estudiado, pues existen multitud de conceptos altamente interesantes en relación al tema. Este será el primer capítulo de mi primera mini serie en mi blog. Podría hablar sobre conceptos y definiciones, pero prefiero explicar cómo se crean datos sintéticos tabulares y qué aplicaciones tienen.]]></summary></entry><entry><title type="html">Optimización combinatoria con GRASP</title><link href="https://migue8gl.dev/2026/08/09/optimizacion-combinatoria-con-grasp.html" rel="alternate" type="text/html" title="Optimización combinatoria con GRASP" /><published>2026-08-09T00:00:00+00:00</published><updated>2026-08-09T00:00:00+00:00</updated><id>https://migue8gl.dev/2026/08/09/optimizacion-combinatoria-con-grasp</id><content type="html" xml:base="https://migue8gl.dev/2026/08/09/optimizacion-combinatoria-con-grasp.html"><![CDATA[<h2 id="no-todo-se-resuelve-con-un-algoritmo-exacto">No todo se resuelve con un algoritmo exacto</h2>
<p>No todos los problemas son igual de complicados. Cuando hablo de la complejidad de un problema, a lo que me refiero es a los recursos que consume una serie de pasos definidos para poder hallar una solución a ese problema. Por lo general, los recursos que utiliza un algoritmo (la serie de pasos definidos y ordenados para solucionar un problema) suelen ser dos, tiempo y espacio. El espacio es la cantidad de información que debemos guardar para poder resolver ese problema. Por ejemplo, ¿cuál es la complejidad de la codificación numérica? Si quiero escribir un número en decimal, por ejemplo $1365$, necesito $4$ caracteres (dígitos). En cambio, para $13454390$ necesito solo $8$ caracteres, pese a que el valor haya crecido enormemente, la cantidad de información para representarlo no lo ha hecho tanto. En general, ya sea en binario, decimal o con otra codificación, si el número es $x$, el número de caracteres que necesito es de orden $n = log(x)$. Esa es su complejidad en espacio definida como una función.</p>

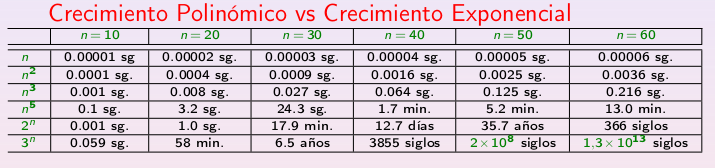
<p>La complejidad temporal indica cuánto trabajo computacional necesita un algoritmo para resolver un problema. Tanto la complejidad en espacio como la temporal dependen del tamaño de entrada del problema. En el ejemplo anterior el tamaño de entrada es el valor del número en sí.</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/optimizacion-combinatoria-con-grasp/time-complexity.png" alt="Tabla de tasas de crecimiento comparadas." width="1000" class="center" />
  <figcaption class="center">Tabla de tasas de crecimiento comparadas.</figcaption>
</figure>

<p>En la tabla se muestran distintos tipos de crecimientos con respecto al tamaño de la entrada. Un problema con complejidad exponencial puede resolverse de forma muy rápida para entradas pequeñas, pero en cuanto crece un poco el tiempo de resolución sale disparado. Por ello, conocer la complejidad de un problema de antemano es necesario en muchos casos para saber aterrizar las expectativas.</p>

<p>El hecho de que existan algoritmos exactos para algunos de estos complejísimos problemas ya es algo por lo que dar gracias. Otros problemas no tienen solución conocida (y posiblemente sea necesario aplicar algoritmos de aprendizaje para encontrar soluciones suficientemente buenas, como bien expliqué en <a href="/2025/12/25/de-que-trata-este-blog">mi primer post</a>). Pero claro, ¿de qué sirve un programa que resuelve el problema si te dará la respuesta en unos pocos años? No es viable esperar esa cantidad de tiempo. Por ello es que existen métodos mucho más rápidos, pero que sacrifican la exactitud por la velocidad. Dentro de estos métodos están, por ejemplo, los <a href="/2025/12/30/algoritmos-geneticos">algoritmos genéticos</a> de los que ya hablé.</p>

<p>Hoy, explicaré otro de estos métodos de búsqueda. El conocido como <strong>GRASP</strong> (<em>Greedy Randomized Adaptive Search Procedure</em>).</p>

<h2 id="problemas-combinatorios">Problemas combinatorios</h2>
<p>El algoritmo de <em>GRASP</em> se utiliza sobre todo en resolución de problemas combinatorios. Un problema es combinatorio cuando las soluciones se construyen mediante combinaciones de elementos discretos, como por ejemplo <a href="/2025/12/30/algoritmos-geneticos.html#el-problema-de-la-mochila">el problema de la mochila</a>, en el que se debe seleccionar un conjunto de objetos a guardar en una mochila, maximizando el valor total y sin pasarse del peso máximo permitido. Este tipo de problemas se pueden solucionar a lo bruto, que es lo primero que se suele intentar. En este caso, procedo a crear todas las combinaciones de objetos dada la restricción del peso máximo. Después, simplemente cojo aquella que tenga mayor valor. ¿Sencillo? Sí. ¿Eficiente? Como tengas una mochila de muchos litros quizá te pases eones esperando a la solución final…</p>

<p>La complejidad del problema de la mochila, resuelto por fuerza bruta, es de $O(2^n)$. Sin entrar en detalles, la $O$ de $O(n)$ viene de <em>“Big O”</em> y sirve para describir cómo crece el coste de un algoritmo cuando aumenta el tamaño de la entrada. En este caso significa que, por fuerza bruta, el número de pasos/operaciones crece con la función $2^n$. Puesto que cada objeto tiene dos posibilidades (cogerlo o no cogerlo) y existen $n$ objetos totales, en el peor de los casos habremos realizado un total de $2^n$ operaciones.</p>

<h3 id="el-problema-del-viajante-tsp">El problema del viajante (TSP)</h3>
<p>El problema del viajante o <em>Traveling Salesman Problem</em> en inglés es el <a href="https://akkologlu.medium.com/hello-world-the-story-of-the-legendary-first-step-in-programming-bb06a623f7f7">“hola mundo”</a> de la optimización. Dada una lista de ciudades y las distancias entre cada par de ellas, ¿cuál es la ruta más corta posible que visite cada ciudad exactamente una vez y al final regrese a la ciudad de origen? El <strong>TSP</strong>, por sus siglas en inglés, tiene diversas aplicaciones en planificación y logística. Es por ello que voy a codificar en <em>Python</em> cómo funciona y voy a resolverlo tanto por fuerza bruta como con <em>GRASP</em>.</p>

<h3 id="definición-formal">Definición formal</h3>
<p>El <strong>TSP</strong> puede ser formulado de la siguiente forma:</p>
<ul>
  <li>Sea $x_{ij}$ igual a $1$, si se elige un camino entre la ciudad $i$ y la ciudad $j$, $0$ en otro caso, para el conjunto de ciudades $0,…,n$. Sea $d_{ij}$ la distancia entre la ciudad $i$ y la ciudad $j$. El conjunto de todas las ciudades es $V$. Dadas estas variables se define el problema de optimización con la función objetivo:</li>
</ul>

\[min\sum_{i=0}^n\sum_{j=0}^nd_{ij}x_{ij}\]

<ul>
  <li>Es decir, se intenta minimizar la distancia total viajada. La restricción es que cada ciudad solo se debe visitar una vez. Es decir, de cada ciudad se sale una vez:</li>
</ul>

\[\sum_{j=0}^nx_{ij}=1, \forall i\in V\]

<ul>
  <li>A cada ciudad se entra solo una vez:</li>
</ul>

\[\sum_{i=0}^nx_{ij}=1, \forall j\in V\]

<ul>
  <li>Y no se puede entrar a la misma ciudad de la que se salió:</li>
</ul>

\[x_{ii}=0, \forall i\in V\]

<p>Este problema es mucho más complejo que el de la mochila. Donde antes se buscaban todas las combinaciones sin importar el orden, ahora se buscan todas las <strong>permutaciones</strong>. Ya no es lo mismo el camino $A\rightarrow B$ que el camino $B\rightarrow A$. Esa pequeña diferencia hace que el problema ya no sea exponencial, sino factorial: $O(n!)$. En términos de crecimiento es una pesadilla.</p>

<h2 id="tsp-en-python">TSP en Python</h2>
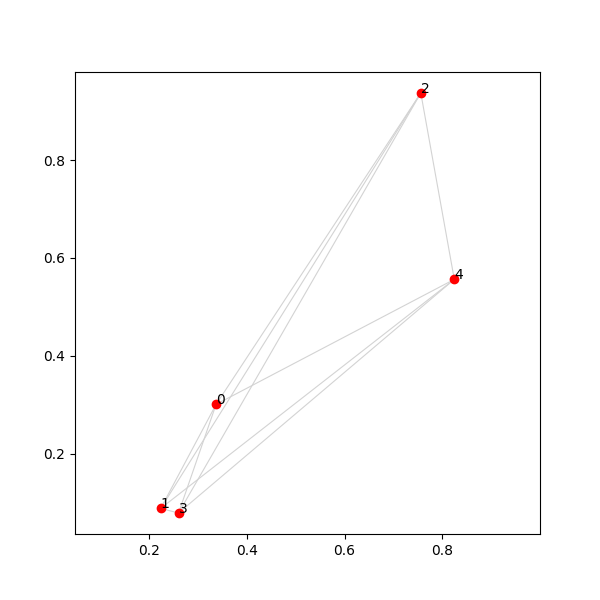
<p>Para poder resolver el problema, primero debemos representarlo. Lo que he hecho es representar en un plano $2D$ las coordenadas de cada ciudad. De esta forma es muy sencillo calcular posteriormente la distancia entre ellas y además podemos visualizar el grafo, que siempre queda muy bonito y hace que cale todo mucho mejor. La siguiente función crea una matriz $N\times 2$ de forma aleatoria donde $N$ es el número de ciudades. Cada ciudad tendrá dos valores, las coordenadas.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">create_cities</span><span class="p">(</span><span class="n">num_cities</span><span class="p">:</span> <span class="nb">int</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">:</span>
    <span class="s">"""Create random coordinates representing a set of cities.

    Args:
        num_cities (int): Number of cities.

    Returns:
        np.ndarray: A matrix containing the coordinates of each city.
    """</span>

    <span class="k">return</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">rand</span><span class="p">(</span><span class="n">num_cities</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
</code></pre></div></div>

<p>Ahora hay que calcular la matriz de distancias. En esta matriz, cada elemento de una fila corresponde a una ciudad y cada elemento de una columna repite las ciudades. De esta forma, codificamos en una estructura matemática las distancias entre cada par de ciudades. Obviamente, esta matriz contendrá la distancia entre una ciudad y ella misma. Estas posiciones corresponden a la diagonal de la matriz. Una forma de hacer este cálculo sería aplicar dos bucles sobre la matriz, de forma que fuese uno a uno computando las distancias. Por suerte, en <em>Numpy</em> existe lo que se conoce como <a href="https://numpy.org/doc/stable/user/basics.broadcasting.html">“broadcasting”</a>, lo cual permite hacer esta operación mucho más eficiente (todos los cálculos se hacen a la vez). En otro post, explicaré en detalle cómo funciona.</p>

<p>La distancia es la distancia euclídea, que en dos dimensiones es:</p>

\[dist = \sqrt{(x_1-x_2)^2 + (y_1-y_2)^2}\]

<p>En <em>Numpy</em> tenemos la conveniente función de <code class="language-plaintext highlighter-rouge">np.linalg.norm</code>.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">create_distance_matrix</span><span class="p">(</span><span class="n">cities</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">:</span>
    <span class="s">"""Create a symmetric distance matrix from a set of city coordinates.

    Args:
        cities (np.ndarray): Matrix containing the coordinates of each city.

    Returns:
        np.ndarray: A symmetric matrix containing the distances between cities.
    """</span>

    <span class="n">diff</span> <span class="o">=</span> <span class="n">cities</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="p">:]</span> <span class="o">-</span> <span class="n">cities</span><span class="p">[</span><span class="bp">None</span><span class="p">,</span> <span class="p">:,</span> <span class="p">:]</span>
    <span class="k">return</span> <span class="n">np</span><span class="p">.</span><span class="n">linalg</span><span class="p">.</span><span class="n">norm</span><span class="p">(</span><span class="n">diff</span><span class="p">,</span> <span class="n">axis</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
</code></pre></div></div>

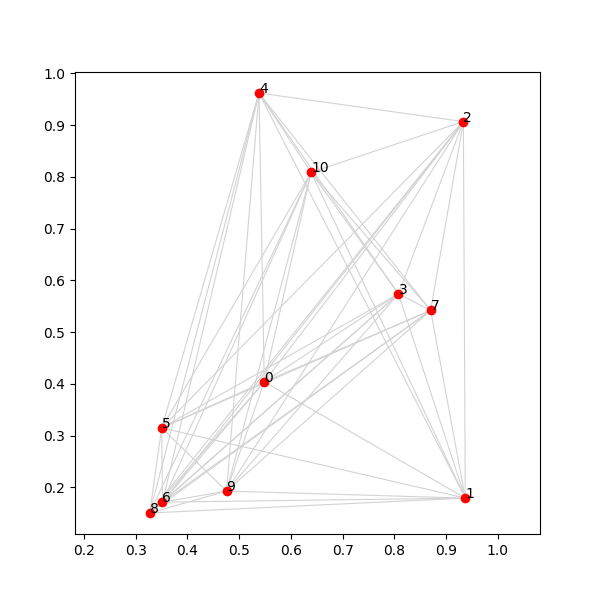
<p>Con estas dos funciones ya podemos visualizar las distintas ciudades en un gráfico y aplicar distintos algoritmos de resolución para encontrar el camino más eficiente de reparto.</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/optimizacion-combinatoria-con-grasp/cities-example.png" alt="Grafo de ciudades." width="400" class="center" />
  <figcaption class="center">Grafo de ciudades.</figcaption>
</figure>

<h2 id="fuerza-bruta">Fuerza bruta</h2>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/optimizacion-combinatoria-con-grasp/tsp-brute-force.gif" alt="Resolución de una instancia de TSP con fuerza bruta. Fuente: https://es.wikipedia.org/wiki/Problema_del_viajante." width="1000" class="center" />
  <figcaption class="center">Resolución de una instancia de TSP con fuerza bruta. Fuente: https://es.wikipedia.org/wiki/Problema_del_viajante.</figcaption>
</figure>

<p>La solución de <strong>TSP</strong> por fuerza bruta no tiene misterio. Debemos crear todas las permutaciones (no combinaciones, aquí sí importa el orden) de caminos posibles dadas las restricciones de que solo se puede pasar una vez por cada ciudad, hay que pasar por todas y hay que volver a la ciudad de origen. Después, seleccionar aquella que tenga la menor distancia total recorrida.</p>

<p>De nuevo, en <em>Python</em> existe la librería <code class="language-plaintext highlighter-rouge">itertools</code> con funciones muy convenientes como <code class="language-plaintext highlighter-rouge">permutations</code>, que nos permite iterar sobre todas las permutaciones posibles de un conjunto dado.</p>

<p>Las siguientes funciones calculan el coste de un camino (necesitamos la matriz de distancia para ver cuánta distancia hay entre dos ciudades y la lista de ciudades que compone un camino) y el algoritmo de búsqueda del camino más corto por fuerza bruta. Es muy sencillo, vamos iterando por cada permutación y la vamos evaluando. Si es la mejor hasta ahora, la guardamos. Así hasta expresar todas las combinaciones. Existen maneras mucho más eficientes de hacer la búsqueda y asegurar que sea exacta, sin metaheurísticas y con garantías, pero hace falta aplicar algoritmos de programación dinámica y estoy bastante oxidado (hay que practicar más <em>Leetcode</em>).</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">tsp_cost</span><span class="p">(</span><span class="n">tour</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">,</span> <span class="n">distance_matrix</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="nb">float</span><span class="p">:</span>
    <span class="s">"""Compute the total cost of a TSP tour.

    The tour is treated as a closed cycle, including the return from the
    last city to the starting city.

    Args:
        tour (np.ndarray): Ordered array of city indices.
        distance_matrix (np.ndarray): Pairwise distance matrix.

    Returns:
        float: Total cost of the tour.
    """</span>

    <span class="n">cost</span> <span class="o">=</span> <span class="mf">0.0</span>

    <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="nb">len</span><span class="p">(</span><span class="n">tour</span><span class="p">)</span> <span class="o">-</span> <span class="mi">1</span><span class="p">):</span>
        <span class="n">cost</span> <span class="o">+=</span> <span class="n">distance_matrix</span><span class="p">[</span><span class="n">tour</span><span class="p">[</span><span class="n">i</span><span class="p">],</span> <span class="n">tour</span><span class="p">[</span><span class="n">i</span> <span class="o">+</span> <span class="mi">1</span><span class="p">]]</span>

    <span class="n">cost</span> <span class="o">+=</span> <span class="n">distance_matrix</span><span class="p">[</span><span class="n">tour</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">],</span> <span class="n">tour</span><span class="p">[</span><span class="mi">0</span><span class="p">]]</span>

    <span class="k">return</span> <span class="n">cost</span>


<span class="k">def</span> <span class="nf">solve_tsp_brute_force</span><span class="p">(</span><span class="n">distance_matrix</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="nb">tuple</span><span class="p">[</span><span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">,</span> <span class="nb">float</span><span class="p">]:</span>
    <span class="s">"""Solve the Traveling Salesman Problem (TSP)

    Args:
        distance_matrix (np.ndarray): A square symmetric matrix of shape
            (n, n), where distance_matrix[i, j] represents the distance
            between cities i and j.

    Returns:
        tuple[np.ndarray, float]:
            - The optimal tour as a NumPy array of city indices, starting
              at city 0.
            - The total length (cost) of the optimal tour, including the
              return from the last city back to the starting city.
    """</span>
    <span class="n">n</span> <span class="o">=</span> <span class="n">distance_matrix</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>
    <span class="n">best_tour</span> <span class="o">=</span> <span class="bp">None</span>
    <span class="n">best_cost</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">inf</span>

    <span class="k">for</span> <span class="n">rest</span> <span class="ow">in</span> <span class="n">permutations</span><span class="p">(</span><span class="nb">range</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">n</span><span class="p">)):</span>
        <span class="n">tour</span> <span class="o">=</span> <span class="p">(</span><span class="mi">0</span><span class="p">,)</span> <span class="o">+</span> <span class="n">rest</span>
        <span class="n">tour_array</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">(</span><span class="n">tour</span><span class="p">)</span>
        <span class="n">tour_cost</span> <span class="o">=</span> <span class="n">tsp_cost</span><span class="p">(</span><span class="n">tour_array</span><span class="p">,</span> <span class="n">distance_matrix</span><span class="p">)</span>

        <span class="k">if</span> <span class="n">best_cost</span> <span class="o">&gt;</span> <span class="n">tour_cost</span><span class="p">:</span>
            <span class="n">best_cost</span> <span class="o">=</span> <span class="n">tour_cost</span>
            <span class="n">best_tour</span> <span class="o">=</span> <span class="n">tour_array</span>

    <span class="k">return</span> <span class="n">best_tour</span><span class="p">,</span> <span class="n">best_cost</span>
</code></pre></div></div>
<h2 id="grasp">GRASP</h2>
<p>El algoritmo <em>GRASP</em> viene a ser una mejora del famoso algoritmo <em>greedy</em> o voraz, por tanto convendría programar una alternativa puramente <em>greedy</em> para compararla tanto con el método por fuerza bruta como con <em>GRASP</em>.</p>

<p>El método <em>greedy</em>, si bien es rápido y obtiene buenas soluciones, muchas veces no es suficiente. Estos tipos de búsqueda tienen una limitación importante, y es que son incapaces de explorar el espacio de búsqueda pues su naturaleza se basa en moverse al siguiente mejor estado, sin considerar nada más que el estado actual. Si el mejor movimiento es moverse de la ciudad $A$ a la ciudad $B$, lo hace. Pero puede ocurrir que, lo que a priori es un mal movimiento, termine resultando en su conjunto una mejor solución. Por ello muchas metaheurísticas incluyen procesos estocásticos, a modo de exploración. En el caso de <em>GRASP</em> se abordan dos fases generales:</p>

<h3 id="exploración">Exploración</h3>
<p>Empezando por la ciudad de origen, <em>GRASP</em> construye de forma incremental una solución seleccionando la siguiente ciudad desde una lista de candidatos restringida (<strong>RCL</strong>). Esta lista contiene a los mejores candidatos en función del criterio <em>greedy</em> (es decir, para <em>TSP</em> es la menor distancia a la ciudad actual). Desde esta lista, para romper con el determinismo de <em>greedy</em>, se elige el candidato al azar. Esta es la fase “exploratoria” y puede controlarse mediante el parámetro $\alpha$.</p>

<p>Este parámetro determina hasta qué punto se relaja el criterio <em>greedy</em> para construir la <em>RCL</em>. Para ello, se establece un umbral entre el coste del mejor y el peor candidato:</p>

\[\text{threshold} = C_{\min} + \alpha(C_{\max} - C_{\min})\]

<p>donde $C_{\min}$ y $C_{\max}$ representan, respectivamente, la menor y la mayor distancia entre los candidatos disponibles. De esta forma, $\alpha$ determina qué proporción del intervalo entre ambos extremos se considera aceptable.</p>

<p>Cuando $\alpha=0$, el umbral coincide con $C_{\min}$, por lo que únicamente el mejor candidato forma parte de la <em>RCL</em>. En consecuencia, el comportamiento es equivalente al de un algoritmo <em>greedy</em>. A medida que aumenta $\alpha$, el umbral se desplaza hacia $C_{\max}$ y se incorporan más candidatos a la <em>RCL</em>, aumentando la diversidad de las soluciones construidas. Con $\alpha=1$, todos los candidatos son aceptados y la siguiente ciudad se selecciona completamente al azar.</p>

<h3 id="explotación">Explotación</h3>
<p>Una vez se construye una solución siguiendo un método <em>pseudo-greedy</em>, se explota mediante una búsqueda local. Este tipo de búsqueda se basa en cambios menores sobre la solución original, cambios en su vecindario más cercano. Son métodos muy rápidos y sencillos de implementar que intentan mejorar al máximo la solución actual, por ello son algoritmos de fase de explotación. Existen muchas implementaciones, pero en mi caso he implementado una búsqueda local sencilla, basada en intercambiar pares de ciudades de posición y aceptar la primera que mejore el costo. La búsqueda termina cuando ya no mejora más.</p>

<p>La fase de exploración y explotación se repiten durante una serie de iteraciones definidas, hasta que no haga mejoras significativas o incluso hasta un tiempo máximo definido. El criterio de parada es muy variado. El código en <em>Python</em> es el siguiente:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">TSP_GRASP</span><span class="p">:</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">max_iterations</span><span class="p">:</span> <span class="nb">int</span> <span class="o">=</span> <span class="mi">20</span><span class="p">,</span> <span class="n">alpha</span><span class="p">:</span> <span class="nb">float</span> <span class="o">=</span> <span class="mf">0.2</span><span class="p">):</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">max_iterations</span> <span class="o">=</span> <span class="n">max_iterations</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">alpha</span> <span class="o">=</span> <span class="n">alpha</span>

    <span class="k">def</span> <span class="nf">build_solution</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">distance_matrix</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">:</span>
        <span class="s">"""Construct a feasible TSP solution using the GRASP construction phase.

        Starting from city 0, the solution is built incrementally by selecting
        the next city from a Restricted Candidate List (RCL). The RCL contains
        the best candidates according to the greedy criterion, and one of them
        is chosen uniformly at random.

        Args:
            distance_matrix (np.ndarray): Pairwise distance matrix.

        Returns:
            np.ndarray: A feasible TSP tour represented as an ordered array of
            city indices.
        """</span>

        <span class="n">n</span> <span class="o">=</span> <span class="n">distance_matrix</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>

        <span class="n">unvisited</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">([</span><span class="n">i</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">n</span><span class="p">)])</span>
        <span class="n">candidates</span> <span class="o">=</span> <span class="p">[]</span>
        <span class="n">solution</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">zeros</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">np</span><span class="p">.</span><span class="n">int64</span><span class="p">)</span>

        <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">n</span> <span class="o">-</span> <span class="mi">1</span><span class="p">):</span>
            <span class="k">for</span> <span class="n">city</span> <span class="ow">in</span> <span class="n">unvisited</span><span class="p">:</span>
                <span class="n">cost</span> <span class="o">=</span> <span class="n">distance_matrix</span><span class="p">[</span><span class="n">solution</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">],</span> <span class="n">city</span><span class="p">]</span>

                <span class="n">candidates</span><span class="p">.</span><span class="n">append</span><span class="p">((</span><span class="n">city</span><span class="p">,</span> <span class="n">cost</span><span class="p">))</span>

            <span class="n">costs</span> <span class="o">=</span> <span class="p">[</span><span class="n">cost</span> <span class="k">for</span> <span class="n">_</span><span class="p">,</span> <span class="n">cost</span> <span class="ow">in</span> <span class="n">candidates</span><span class="p">]</span>
            <span class="n">min_cost</span> <span class="o">=</span> <span class="nb">min</span><span class="p">(</span><span class="n">costs</span><span class="p">)</span>
            <span class="n">max_cost</span> <span class="o">=</span> <span class="nb">max</span><span class="p">(</span><span class="n">costs</span><span class="p">)</span>

            <span class="n">threshold</span> <span class="o">=</span> <span class="n">min_cost</span> <span class="o">+</span> <span class="bp">self</span><span class="p">.</span><span class="n">alpha</span> <span class="o">*</span> <span class="p">(</span><span class="n">max_cost</span> <span class="o">-</span> <span class="n">min_cost</span><span class="p">)</span>
            <span class="n">rcl</span> <span class="o">=</span> <span class="p">[</span><span class="n">city</span> <span class="k">for</span> <span class="n">city</span><span class="p">,</span> <span class="n">cost</span> <span class="ow">in</span> <span class="n">candidates</span> <span class="k">if</span> <span class="n">cost</span> <span class="o">&lt;=</span> <span class="n">threshold</span><span class="p">]</span>
            <span class="n">next_city</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">choice</span><span class="p">(</span><span class="n">rcl</span><span class="p">)</span>
            <span class="n">solution</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">solution</span><span class="p">,</span> <span class="n">next_city</span><span class="p">)</span>

            <span class="n">unvisited</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">setdiff1d</span><span class="p">(</span><span class="n">unvisited</span><span class="p">,</span> <span class="p">[</span><span class="n">next_city</span><span class="p">])</span>
            <span class="n">candidates</span> <span class="o">=</span> <span class="p">[]</span>
        <span class="k">return</span> <span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">(</span><span class="n">solution</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">local_search</span><span class="p">(</span>
        <span class="bp">self</span><span class="p">,</span> <span class="n">solution</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">,</span> <span class="n">distance_matrix</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span>
    <span class="p">)</span> <span class="o">-&gt;</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">:</span>
        <span class="s">"""Improve a TSP solution using a swap-based local search.

        The algorithm iteratively swaps pairs of cities and accepts the first
        improving move. The process stops when no improving swap is found.

        Args:
            solution (np.ndarray): Initial TSP tour.
            distance_matrix (np.ndarray): Pairwise distance matrix.

        Returns:
            np.ndarray: Locally improved TSP tour.
        """</span>

        <span class="n">best_solution</span> <span class="o">=</span> <span class="n">solution</span><span class="p">.</span><span class="n">copy</span><span class="p">()</span>
        <span class="n">best_cost</span> <span class="o">=</span> <span class="n">tsp_cost</span><span class="p">(</span><span class="n">best_solution</span><span class="p">,</span> <span class="n">distance_matrix</span><span class="p">)</span>

        <span class="n">improved</span> <span class="o">=</span> <span class="bp">True</span>

        <span class="k">while</span> <span class="n">improved</span><span class="p">:</span>
            <span class="n">improved</span> <span class="o">=</span> <span class="bp">False</span>

            <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="nb">len</span><span class="p">(</span><span class="n">solution</span><span class="p">)</span> <span class="o">-</span> <span class="mi">1</span><span class="p">):</span>
                <span class="k">for</span> <span class="n">j</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">i</span> <span class="o">+</span> <span class="mi">1</span><span class="p">,</span> <span class="nb">len</span><span class="p">(</span><span class="n">solution</span><span class="p">)):</span>
                    <span class="n">candidate</span> <span class="o">=</span> <span class="n">best_solution</span><span class="p">.</span><span class="n">copy</span><span class="p">()</span>
                    <span class="n">candidate</span><span class="p">[</span><span class="n">i</span><span class="p">],</span> <span class="n">candidate</span><span class="p">[</span><span class="n">j</span><span class="p">]</span> <span class="o">=</span> <span class="n">candidate</span><span class="p">[</span><span class="n">j</span><span class="p">],</span> <span class="n">candidate</span><span class="p">[</span><span class="n">i</span><span class="p">]</span>

                    <span class="n">candidate_cost</span> <span class="o">=</span> <span class="n">tsp_cost</span><span class="p">(</span><span class="n">candidate</span><span class="p">,</span> <span class="n">distance_matrix</span><span class="p">)</span>

                    <span class="k">if</span> <span class="n">candidate_cost</span> <span class="o">&lt;</span> <span class="n">best_cost</span><span class="p">:</span>
                        <span class="n">best_solution</span> <span class="o">=</span> <span class="n">candidate</span>
                        <span class="n">best_cost</span> <span class="o">=</span> <span class="n">candidate_cost</span>
                        <span class="n">improved</span> <span class="o">=</span> <span class="bp">True</span>
                        <span class="k">break</span>

                <span class="k">if</span> <span class="n">improved</span><span class="p">:</span>
                    <span class="k">break</span>

        <span class="k">return</span> <span class="n">best_solution</span>

    <span class="k">def</span> <span class="nf">optimize</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">distance_matrix</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="nb">tuple</span><span class="p">[</span><span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">,</span> <span class="nb">float</span><span class="p">]:</span>
        <span class="n">best_solution</span> <span class="o">=</span> <span class="bp">None</span>
        <span class="n">best_cost</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">inf</span>

        <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="bp">self</span><span class="p">.</span><span class="n">max_iterations</span><span class="p">):</span>
            <span class="n">solution</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">build_solution</span><span class="p">(</span><span class="n">distance_matrix</span><span class="p">)</span>

            <span class="n">solution</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">local_search</span><span class="p">(</span><span class="n">solution</span><span class="p">,</span> <span class="n">distance_matrix</span><span class="p">)</span>

            <span class="n">cost</span> <span class="o">=</span> <span class="n">tsp_cost</span><span class="p">(</span><span class="n">solution</span><span class="p">,</span> <span class="n">distance_matrix</span><span class="p">)</span>

            <span class="k">if</span> <span class="n">cost</span> <span class="o">&lt;</span> <span class="n">best_cost</span><span class="p">:</span>
                <span class="n">best_solution</span> <span class="o">=</span> <span class="n">solution</span>
                <span class="n">best_cost</span> <span class="o">=</span> <span class="n">cost</span>

        <span class="k">return</span> <span class="n">best_solution</span><span class="p">,</span> <span class="n">best_cost</span>
</code></pre></div></div>

<h2 id="resultados">Resultados</h2>
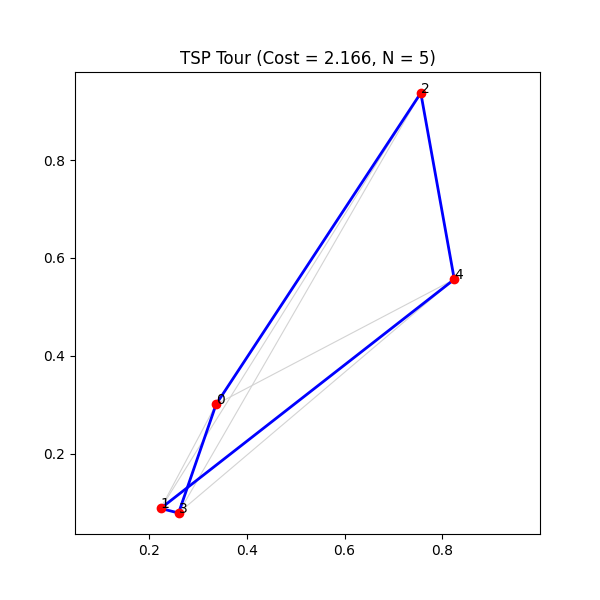
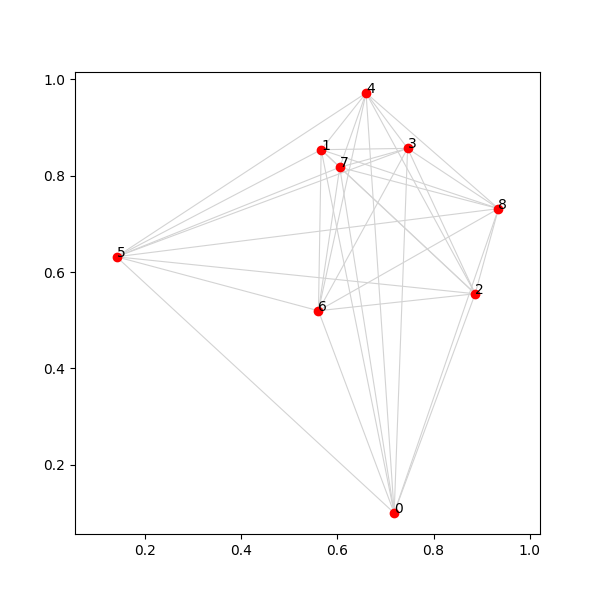
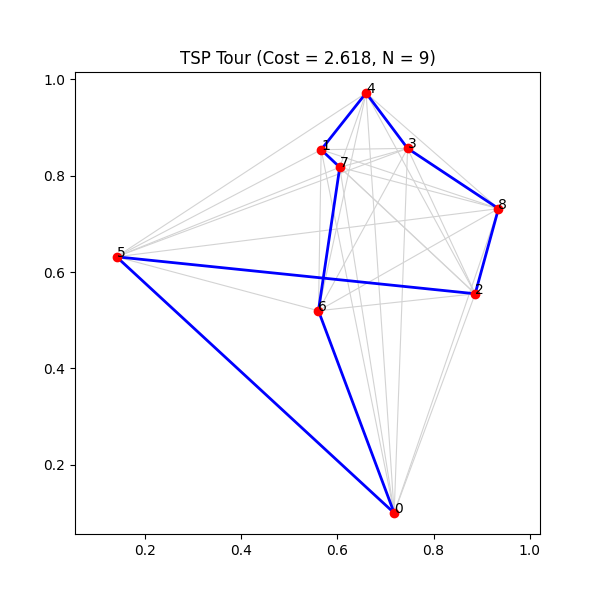
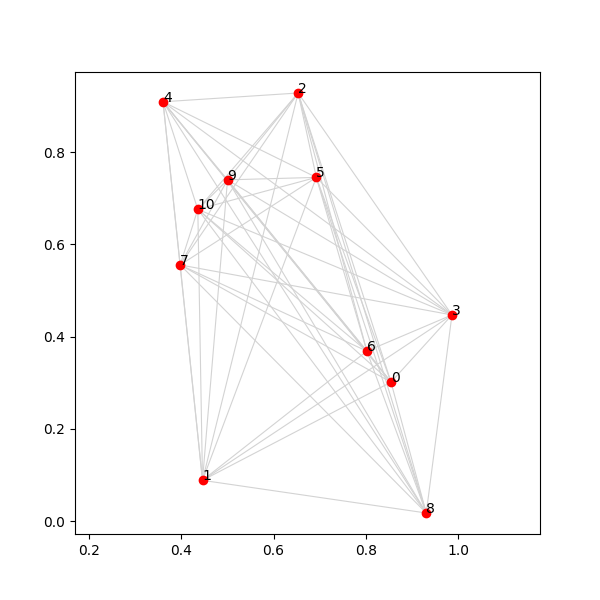
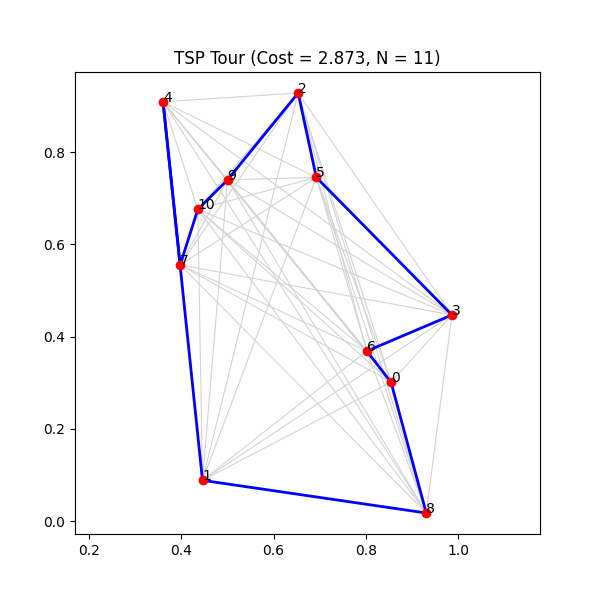
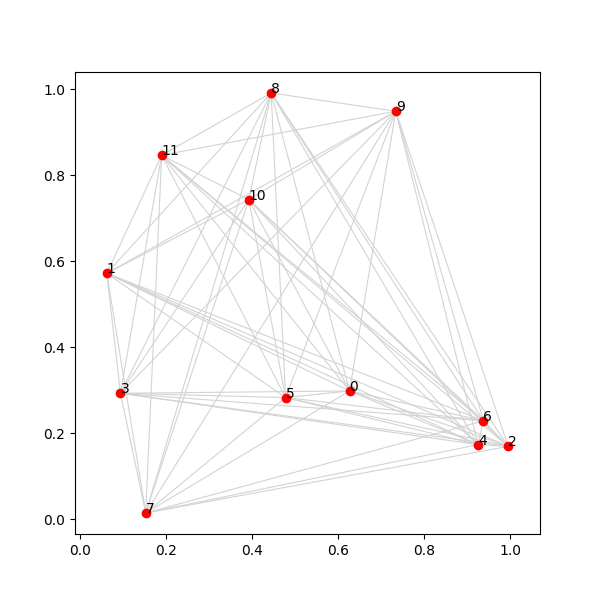
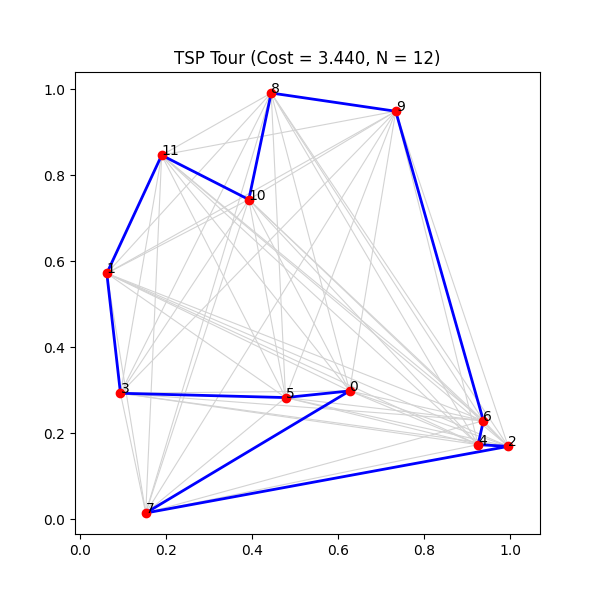
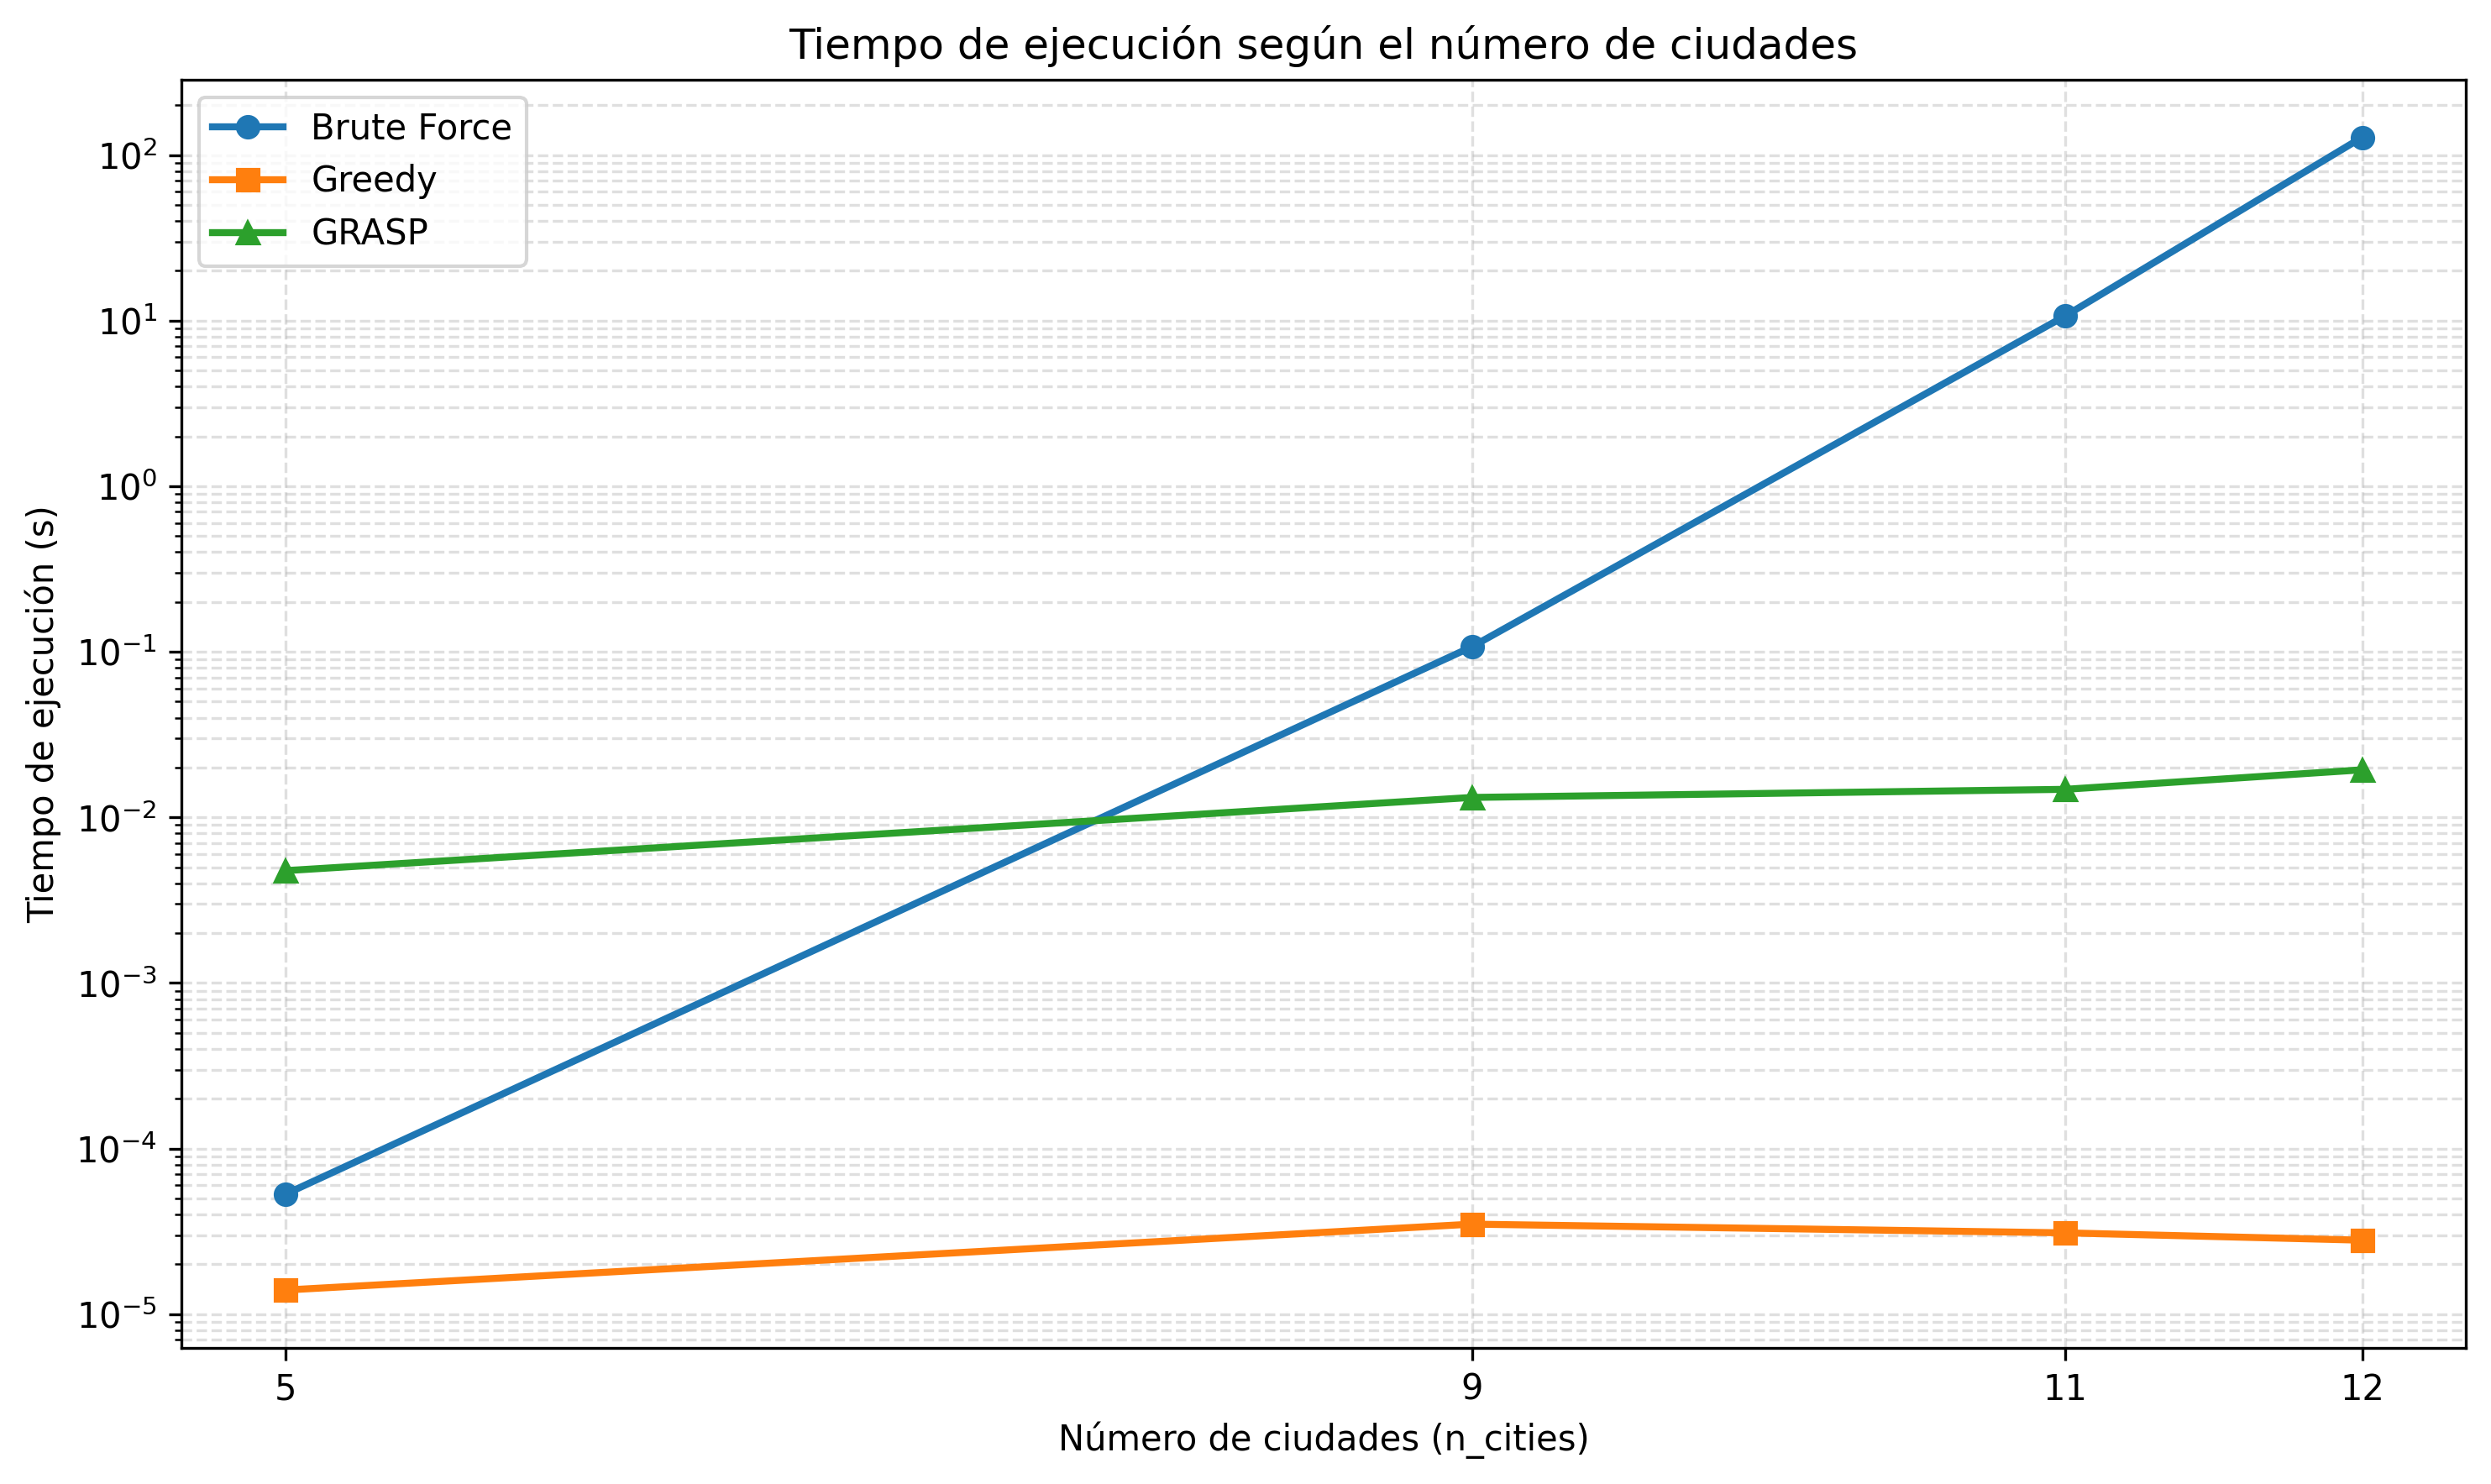
<p>Ha llegado la hora de comparar las tres opciones propuestas, la fuerza bruta, el voraz básico y <em>GRASP</em>. Aquí los resultados para <em>TSP</em> con $5, 9, 11$ y $12$ ciudades:</p>

<table>
  <thead>
    <tr>
      <th style="text-align: center">Algorithm</th>
      <th style="text-align: center">n_cities</th>
      <th style="text-align: center">execution_time_s</th>
      <th style="text-align: center">tour_cost</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: center">Brute Force</td>
      <td style="text-align: center">5</td>
      <td style="text-align: center">0.000052</td>
      <td style="text-align: center">2.1657752216052906</td>
    </tr>
    <tr>
      <td style="text-align: center">Greedy</td>
      <td style="text-align: center">5</td>
      <td style="text-align: center">0.000018</td>
      <td style="text-align: center">2.1821739012227956</td>
    </tr>
    <tr>
      <td style="text-align: center">GRASP</td>
      <td style="text-align: center">5</td>
      <td style="text-align: center">0.004553</td>
      <td style="text-align: center">2.1657752216052906</td>
    </tr>
  </tbody>
</table>

<!-- _includes/image_grid.html -->
<figure class="image-grid">
  <div class="image-row">
    
    
      <img src="/assets/images/optimizacion-combinatoria-con-grasp/cities-5.png" alt="Grafo de las 5 ciudades frente a la solución encontrada por GRASP." class="grid-image" />


      <img src="/assets/images/optimizacion-combinatoria-con-grasp/best_tour-5.png" alt="Grafo de las 5 ciudades frente a la solución encontrada por GRASP." class="grid-image" />


  </div>
  <figcaption class="center">Grafo de las 5 ciudades frente a la solución encontrada por GRASP.</figcaption>
</figure>

<table>
  <thead>
    <tr>
      <th style="text-align: center">Algorithm</th>
      <th style="text-align: center">n_cities</th>
      <th style="text-align: center">execution_time_s</th>
      <th style="text-align: center">tour_cost</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: center">Brute Force</td>
      <td style="text-align: center">9</td>
      <td style="text-align: center">0.107380</td>
      <td style="text-align: center">2.6180824541699557</td>
    </tr>
    <tr>
      <td style="text-align: center">Greedy</td>
      <td style="text-align: center">9</td>
      <td style="text-align: center">0.000035</td>
      <td style="text-align: center">3.0401040631190206</td>
    </tr>
    <tr>
      <td style="text-align: center">GRASP</td>
      <td style="text-align: center">9</td>
      <td style="text-align: center">0.013204</td>
      <td style="text-align: center">2.6180824541699557</td>
    </tr>
  </tbody>
</table>

<!-- _includes/image_grid.html -->
<figure class="image-grid">
  <div class="image-row">
    
    
      <img src="/assets/images/optimizacion-combinatoria-con-grasp/cities-9.png" alt="Grafo de las 9 ciudades frente a la solución encontrada por GRASP." class="grid-image" />


      <img src="/assets/images/optimizacion-combinatoria-con-grasp/best_tour-9.png" alt="Grafo de las 9 ciudades frente a la solución encontrada por GRASP." class="grid-image" />


  </div>
  <figcaption class="center">Grafo de las 9 ciudades frente a la solución encontrada por GRASP.</figcaption>
</figure>

<table>
  <thead>
    <tr>
      <th style="text-align: center">Algorithm</th>
      <th style="text-align: center">n_cities</th>
      <th style="text-align: center">execution_time_s</th>
      <th style="text-align: center">tour_cost</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: center">Brute Force</td>
      <td style="text-align: center">11</td>
      <td style="text-align: center">10.690878</td>
      <td style="text-align: center">2.8734761900015102</td>
    </tr>
    <tr>
      <td style="text-align: center">Greedy</td>
      <td style="text-align: center">11</td>
      <td style="text-align: center">0.000031</td>
      <td style="text-align: center">3.3140517561088605</td>
    </tr>
    <tr>
      <td style="text-align: center">GRASP</td>
      <td style="text-align: center">11</td>
      <td style="text-align: center">0.014780</td>
      <td style="text-align: center">2.8734761900015102</td>
    </tr>
  </tbody>
</table>

<!-- _includes/image_grid.html -->
<figure class="image-grid">
  <div class="image-row">
    
    
      <img src="/assets/images/optimizacion-combinatoria-con-grasp/cities-11.png" alt="Grafo de las 11 ciudades frente a la solución encontrada por GRASP." class="grid-image" />


      <img src="/assets/images/optimizacion-combinatoria-con-grasp/best_tour-11.png" alt="Grafo de las 11 ciudades frente a la solución encontrada por GRASP." class="grid-image" />


  </div>
  <figcaption class="center">Grafo de las 11 ciudades frente a la solución encontrada por GRASP.</figcaption>
</figure>

<table>
  <thead>
    <tr>
      <th style="text-align: center">Algorithm</th>
      <th style="text-align: center">n_cities</th>
      <th style="text-align: center">execution_time_s</th>
      <th style="text-align: center">tour_cost</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: center">Brute Force</td>
      <td style="text-align: center">12</td>
      <td style="text-align: center">127.815707</td>
      <td style="text-align: center">3.439504983165455</td>
    </tr>
    <tr>
      <td style="text-align: center">Greedy</td>
      <td style="text-align: center">12</td>
      <td style="text-align: center">0.000028</td>
      <td style="text-align: center">4.177233605024462</td>
    </tr>
    <tr>
      <td style="text-align: center">GRASP</td>
      <td style="text-align: center">12</td>
      <td style="text-align: center">0.019386</td>
      <td style="text-align: center">3.439504983165455</td>
    </tr>
  </tbody>
</table>

<!-- _includes/image_grid.html -->
<figure class="image-grid">
  <div class="image-row">
    
    
      <img src="/assets/images/optimizacion-combinatoria-con-grasp/cities-12.png" alt="Grafo de las 11 ciudades frente a la solución encontrada por GRASP." class="grid-image" />


      <img src="/assets/images/optimizacion-combinatoria-con-grasp/best_tour-12.png" alt="Grafo de las 11 ciudades frente a la solución encontrada por GRASP." class="grid-image" />


  </div>
  <figcaption class="center">Grafo de las 11 ciudades frente a la solución encontrada por GRASP.</figcaption>
</figure>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/optimizacion-combinatoria-con-grasp/execution_time_vs_n_cities.png" alt="Tiempo de ejecución de distintos algoritmos según crece el tamaño de entrada en TSP." width="1000" class="center" />
  <figcaption class="center">Tiempo de ejecución de distintos algoritmos según crece el tamaño de entrada en TSP.</figcaption>
</figure>

<p>Como puede observarse, el algoritmo por fuerza bruta no es una opción que pueda utilizarse en la vida real. Ni paralelizándolo ni usando una versión más eficiente por programación dinámica sería usable, todas las versiones alcanzarían en algún punto tiempos imposibles. Mientras tanto, las versiones de <em>greedy</em> y <em>GRASP</em> pueden crecer y crecer y seguir siendo veloces al encontrar la solución. En estos resultados además se observa la diferencia clave entre ambos. El algoritmo voraz no encuentra nunca el óptimo global en las pruebas realizadas, mientras que <em>GRASP</em> lo hace siempre.</p>

<p>Hay que entender que <em>GRASP</em> no garantiza el óptimo global como sí lo hace la fuerza bruta, pero es capaz de aproximar el valor y obtener soluciones suficientemente buenas. Todo ello haciendo un simple cambio al <em>greedy</em> de toda la vida.</p>]]></content><author><name></name></author><category term="ia" /><category term="optimización" /><category term="inteligencia artificial" /><category term="optimization" /><category term="grasp" /><category term="greedy" /><category term="metaheuristics" /><category term="tsp" /><category term="artificial intelligence" /><summary type="html"><![CDATA[La optimización es un tema que me apasiona desde hace años. El primer post que subí a este blog ya mencionaba las metaheurísticas y en el segundo traté los algoritmos genéticos. En este post explicaré el algoritmo GRASP, cómo funciona y por qué funciona. Es un algoritmo de optimización pseudo-estocástico de diseño simple, pero con grandes aplicaciones.]]></summary></entry><entry><title type="html">La democratización de la inteligencia, o de la estupidez</title><link href="https://migue8gl.dev/2026/07/06/la-democratizacion-de-la-inteligencia-o-de-la-estupidez.html" rel="alternate" type="text/html" title="La democratización de la inteligencia, o de la estupidez" /><published>2026-07-06T00:00:00+00:00</published><updated>2026-07-06T00:00:00+00:00</updated><id>https://migue8gl.dev/2026/07/06/la-democratizacion-de-la-inteligencia-o-de-la-estupidez</id><content type="html" xml:base="https://migue8gl.dev/2026/07/06/la-democratizacion-de-la-inteligencia-o-de-la-estupidez.html"><![CDATA[<h2 id="la-democratización-de-la-inteligencia">La democratización de la inteligencia…</h2>
<p>Hoy me apetece escribir. Llevo unos mesecillos un tanto ajetreados entre el trabajo, lo personal y la finalización de mi trabajo de fin de máster. Toda esa carga ha hecho que tenga menos tiempo y ganas de escribir por aquí. Además, tengo otros <em>hobbies</em> que atender. Seguramente empiece poco a poco a retomarlo, a escribir más, pero <em>posts</em> más cortos, con menos carga teórica y sin programación de por medio. Al fin y al cabo, para eso inicié este <em>blog</em>, para escribir más y disfrutar en el camino, no para añadirme otra carga todas las semanas, no para añadirme a la fuerza conceptos y tecnologías nuevas que aprender.</p>

<p>Hoy quería escribir sobre el concepto de democratización de la inteligencia, algo de lo que se ha hablado bastante desde que la masa descubrió a <em>ChatGPT</em>. Si no recuerdo mal, descubrí <em>GPT</em> (que no <em>ChatGPT</em>) con los vídeos de <a href="https://www.youtube.com/@DotCSV">DotCSV</a>, cuando estaba en segundo o tercero de carrera, allá por el $2020-2021$. Jugaba en un entorno de pruebas con una red neuronal capaz de generar texto. Sin embargo, a partir de los pocos párrafos dejaba de tener sentido nada de lo que ese modelo escribiera, pero el hecho de poder escribir siquiera algo con el más mínimo sentido era una bomba. Desde entonces los modelos de lenguaje han tenido una evolución exponencial en cuanto a sus capacidades. El contexto (explicado como la cantidad de información que pueden contener en una sola sesión) que manejan es gigantesco, su conocimiento abarca todo <em>Internet</em> y más allá. Son capaces de programar mejor que cualquier recién graduado y de generar textos casi indistinguibles de un ser humano. También se hicieron <em>mainstream</em>, y con ello, las grandes masas conocerían lo que era la <em>IA</em>.</p>

<p>Personalmente, como alguien que ha estudiado Ingeniería Informática, especializándose en sistemas inteligentes y computación (viene a ser la rama de <em>IA</em>), he de reconocer que me dio un poco de coraje. El conjunto de métodos que llamamos <em>Inteligencia Artificial</em> han existido desde hace décadas. Los algoritmos genéticos, los sistemas de conocimiento, algoritmos de búsqueda de caminos, el <em>machine learning</em> en general, han sido considerados <em>IA</em> desde hace mucho. Los <em>LLMs</em> no son más que redes neuronales entrenadas con todo el texto conocido (simplificando mucho). Pero mi desagrado con el nuevo cambio de concepto de la <em>IA</em> no viene del propio viraje de significado a nivel general, que como friki petardo algo sí que me molesta (pero es natural y lo entiendo). Viene más bien del auge de los <strong>expertos en IA</strong>. ¿Quiénes son estos expertos? Cantamañanas y buscavidas que, en su mayoría, descubrieron la <em>IA</em> ayer (con ayer me refiero a un par de meses antes que el público general). Son la evolución de los <em>crypto bros</em> o los pesados de los <em>NFTs</em>. De este tipo de personas está el mundo lleno y no es, a priori, tan malo. Lo malo es que están por doquier y no solo en los anuncios petardos de redes sociales. Antes te intentaban vender cursos, pero eran cuatro gatos. Ahora están en todos lados, en el trabajo, en la familia, en todos tus círculos.</p>

<p>Esas personas antes se podían ignorar, pero ahora ya no, son una <strong>masa</strong>. El mercado está lleno de personas que han hecho un giro de $180$ grados con su profesión, ahora son expertos en <em>IA</em>, ahora son <em>prompt engineers</em>. Se han formado con cursos de otros expertos en <em>IA</em> que en su mayoría tienen un contenido pobre, nada técnico y que en algunos casos roza lo absurdo. Muchos sectores han virado hacia la nueva <em>IA</em> y se habla mucho de democratización de la inteligencia, que viene a significar que ya no hace falta usar mucho el coco para hacer cosas mínimamente complicadas. ¿De verdad es así? Hablando sobre lo que sé, la informática, ¿está ocurriendo? Pues en parte sí. Al principio usábamos los <em>LLMs</em> para generar trozos de código, para ayudarnos y darnos un extra de velocidad, pero es que ya estamos en un punto en el que se generan proyectos en dos días, proyectos que antes podrían haber durado cuatro meses.</p>

<p>He vivido en mis propias carnes lo que es ir poco a poco convirtiéndote de un programador a un supervisor de la <em>IA</em>. Antes pensaba, planeaba, me informaba y volvía a planear, luego programaba y después corregía. Todo ese proceso me hacía sentir pleno en mi trabajo, le daba un sentido. Tenía que trabajar con un conjunto de restricciones y resolver un problema que podía ser más o menos trivial, pero todo ese proceso, aunque lento, era estimulante, gratificante. Poco a poco, te hacía mejor profesional. Ser supervisor de la <em>IA</em> le quita toda la gracia y creo que traerá serios problemas en el futuro. Hoy, se usan agentes potentísimos de <em>IA</em> que hacen que la resolución de un <em>bug</em> menor, la cual podía tenerte ocupado un par de horas o incluso un día, se resuelva con un <em>prompt</em>. Los proyectos de meses son ahora realizados en dos días. El precio a pagar es tener que sentarte a hablar con un bicho que a todas luces es un tarugo, pero que te escupe código medio funcional en segundos (eso sin contar el doloroso precio por <em>token</em>). Es decir, has estudiado complejos algoritmos, tienes nociones de diseño de sistemas eficientes e inteligentes, eres capaz de resolver problemas porque a eso se dedica un ingeniero informático, para terminar dándote cabezazos contra la pared porque <em>Claude Code</em> no te hace caso.</p>

<p>Pues nada, esas capacidades ya no son del todo requeridas. Obviamente sí que son importantes, pero el baremo ha bajado y ahora hay muchas más personas capaces de dedicarse a la programación. Se sigue necesitando a una persona formada, ya que no es viable desplegar proyectos enteros sin la supervisión de un experto. La <em>IA</em> sigue cometiendo fallos garrafales y no es seguro. De ahí viene parte de la “democratización de inteligencia”, de la bajada del baremo. Pero, ¿y los que ya se dedicaban a esto antes de los <em>LLMs</em>? Pues muchos, si no son la mayoría, están siendo obligados directa o indirectamente a programar con <em>IA</em>, ya sea porque el ritmo de entrega se ha visto acelerado, porque son adictos o porque les obligan directamente. Y con ello viene pensar menos. Ya no hay que devanarse los sesos, solo preguntarle al bicho y revisar que medio esté bien. Sinceramente, no lo veo muy mantenible en el tiempo.</p>

<h2 id="o-de-la-estupidez">…o de la estupidez</h2>
<p>Llamadme loco, conspiranoico o hipocondríaco, pero yo noto un bajón delirante en todo lo relacionado con el <em>software</em>. Lo he notado en mis propias carnes al interactuar con decenas de páginas <em>web</em> que uso semanalmente desde hace años y con programas concretos. No solo eso, sino que la cantidad de noticias de nuevas filtraciones de datos en empresas ha crecido, o siento que ha crecido, muchísimo. No uso <em>Windows</em> como sistema operativo personal (dios me libre), pero claramente el <a href="https://youtu.be/2-YLE1BKpeA">vibe coding</a> no está ayudando a que <em>Microsoft</em> deje de ser <strong>Microslop</strong>.</p>

<p>La calidad del <em>software</em> ha decaído y, con ella, también se degradan poco a poco las capacidades del programador. En mi caso concreto, si no fuera porque disfruto de mi trabajo y consumo contenido de informática, artículos técnicos, <em>machine learning</em> y otras áreas relacionadas, probablemente ya tendría la babilla caída de tanto <em>vibe codear</em>. Por suerte, mi trabajo ha cambiado y ahora puedo dedicarme a tareas más estimulantes, utilizando la <em>IA</em> como un apoyo puntual en lugar de como una muleta. Aun así, el deterioro de mis habilidades como programador fue real. Y mi caso no es aislado, le ocurre a todo el mundo en mayor o menor medida y en casi todos los sectores, no solo en programación. Es una muerte lenta. Por ello, creo que hoy se está produciendo un intercambio peligroso en el que se está sacrificando una mayor velocidad y “eficiencia” a corto plazo por una degradación lenta, pero continua, de la capacidad de análisis crítico y de la razón. Y lo de eficiencia entre comillas porque la deuda técnica se ha multiplicado por mil y a ver quien es el listo que va a mantener ese pedazo de troncho de programa que no entiende ni la propia <em>IA</em> que lo creó. Además, ¿a cuántos de vosotros os da miedo la página en blanco? Siempre lo ha dado, pero ahora podemos rellenarla ya de ya. La consecuencia de esto es una menor creatividad, una degradación de la calidad del trabajo realizado y una lenta castración.</p>

<p>Esto es algo que ocurre a niveles bajos en la jerarquía laboral, pero los <em>CEOs</em>, directivos, personas en general que se dediquen a la organización y gestión de otros, también sufren de esto. Los <em>LLMs</em> son como un psicólogo incompetente que en vez de ayudarte te autovalida. Te da la razón y encima te da argumentos falaces para justificar cada subnormalidad que uno pueda llegar a pensar. Es como la gente que se apoya en “artículos científicos” para explicarte por qué comer &lt;inserte aquí cualquier tipo de alimento&gt; es nocivo para la salud, pero con esteroides. Y eso, para alguien cuya responsabilidad consiste en tomar decisiones que afectan a decenas o cientos de personas, además del rumbo de la propia empresa como entidad, es peligrosísimo. El valor de una organización no está solo en ejecutar, sino en confrontar ideas, escuchar a quienes saben más que tú en cada área y dejar que tus decisiones sobrevivan al escrutinio de otros. Si sustituyes ese proceso por una conversación con un modelo cuyo objetivo principal es resultar útil y convincente, corres el riesgo de encerrarte en una cámara de eco extremadamente sofisticada. ¿Se darán cuenta de esto a la larga y a las malas? O quizá nos reorganicemos de otro modo más eficiente y todo salga genial. Yo no soy conocedor de la verdad.</p>

<p>Quizá no importe mucho, quizá la <em>IA</em> mejore tanto que estos pequeños errores ya no sean un problema y la inteligencia humana y el criterio queden en un segundo plano. Yo lo dudo. Los <em>LLMs</em> son uno de los mayores avances tecnológicos de los últimos años, pero tienen problemas serios inherentes a su naturaleza y eso lo están notando hasta las empresas como <em>OpenAI</em> y <em>Anthropic</em>. La escala por fuerza bruta se está acabando, por no hablar ya de otros problemas como el del <strong>autoconsumo</strong>. La <em>IA</em> se alimentó de la inteligencia colectiva de <em>Internet</em>, pero ahora corre el riesgo de alimentarse de su propio reflejo, pero eso es otro tema.</p>

<p>Siendo positivos, todo convergerá, como ha ocurrido siempre con todas estas cosas, a un punto medio mucho más razonable. Ocurrió con la burbuja <em>dot-com</em>, con las criptomonedas, los coches eléctricos o incluso el <em>Big Data</em>. Primero llega la euforia, después la decepción, y finalmente la adopción real. Solo necesita tiempo. Y siendo negativos, pues quizá haya que ir aprendiendo la profesión de fontanería.</p>]]></content><author><name></name></author><category term="ia" /><category term="disertación" /><category term="llm" /><category term="reflexion" /><category term="inteligencia artificial" /><category term="chatgpt" /><category term="pensamiento critico" /><category term="futuro" /><category term="opinion" /><category term="artificial intelligence" /><summary type="html"><![CDATA[La inteligencia artificial o, más concretamente, los LLMs (como yo prefiero referirme a esta tecnología), han supuesto un cambio de paradigma en muchos sectores como el educativo, el personal o el laboral. Se habla de democratización de la inteligencia, pero mis experiencias más cercanas me transmiten lo contrario.]]></summary></entry><entry><title type="html">El aprendiz y el maestro: cómo comprimir la inteligencia</title><link href="https://migue8gl.dev/2026/06/07/el-aprendiz-y-el-maestro-como-comprimir-inteligencia.html" rel="alternate" type="text/html" title="El aprendiz y el maestro: cómo comprimir la inteligencia" /><published>2026-06-07T00:00:00+00:00</published><updated>2026-06-07T00:00:00+00:00</updated><id>https://migue8gl.dev/2026/06/07/el-aprendiz-y-el-maestro-como-comprimir-inteligencia</id><content type="html" xml:base="https://migue8gl.dev/2026/06/07/el-aprendiz-y-el-maestro-como-comprimir-inteligencia.html"><![CDATA[<h2 id="introducción">Introducción</h2>
<p>Hace ya un tiempo que quería implementar lo que vengo conociendo como la técnica <em>teacher-student</em>. La he visto en otros blogs, en vídeos de <em>Youtube</em>, en foros, etc. Siempre me ha parecido muy vistosa y bastante sencilla de implementar. La idea es simple, coges una red neuronal muy grande y tratas de copiar sus salidas mientras entrenas una red mucho más pequeña. De ahí viene el nombre de <em>teacher-student</em>, ya que una red (profesora) muestra sus conocimientos a otra red que la imita (estudiante). Los blogs que leía en su momento hablaban sobre minimizar la divergencia <strong>Kullback-Leibler</strong> entre la distribución de los <a href="https://stackoverflow.com/questions/41455101/what-is-the-meaning-of-the-word-logits-in-tensorflow">logits</a> del profesor y del estudiante. La distancia <em>Kullback-Leibler</em>, a la que me voy a empezar a referir como <em>KL</em> por simplicidad, cuantifica la diferencia entre dos distribuciones de probabilidad. No es una distancia (matemáticamente hablando), pero como si lo fuera para nosotros.</p>

<h3 id="no-era-tan-sencillo">No era tan sencillo</h3>
<p>Pues bien, resulta que no es tan sencillo sacarle el jugo a esta técnica. Para la escritura de estos <em>posts</em> suelo programar algún que otro <em>script</em> de <em>Python</em> para mostrar cómo se hacen las cosas y también para desengrasarme un poco, que al final estos <em>posts</em> son sobre todo para mí. El tema es, que es bastante más delicado de lo que me imaginaba. Las primeras veces tiraba de un modelo como <em>ResNet-18</em> o <em>ResNet-50</em> para aprender a clasificar datos del problema de <a href="https://www.cs.toronto.edu/~kriz/cifar.html">CIFAR</a> (imágenes de objetos y animales de $32\times 32$ píxeles). Muchas veces la red se sobreajustaba, lo cual es muy común en redes con demasiados parámetros (algún día hablaré de ello). Cuando una red se sobreajusta, significa que memoriza los datos de entrenamiento, los cuales incluyen ruido, lo cual hace que el modelo no rinda bien en datos nunca vistos. Eso tiene fácil solución, aplicamos <em>early stopping</em>. Luego, entrené a dos modelos pequeños, quizá demasiado pequeños. Uno de ellos aprendería de forma tradicional a clasificar las imágenes de <em>CIFAR-10</em> y el otro imitaría al modelo profesor. Ninguno rendía bien, de hecho el que peor iba era el modelo que usaba técnicas de destilación de conocimiento. Quizá son demasiado pequeñas, pensé. Procedí a aumentar los tamaños de las redes estudiante y los resultados fueron distintos. Esta vez, la red pequeña sin destilar conseguía un resultado mejor que el profesor, incluso, mientras que la destilada era peor. En este caso puede tener sentido, si la red profesor ni siquiera supera a sus propios alumnos, ¿qué narices va a enseñar?</p>

<p>Tras varias iteraciones sin conseguir nada hice lo que debería haber hecho en un inicio, leer el <em>paper</em> original para ver si se me había pasado algo. Este artículo se puede encontrar <a href="https://arxiv.org/abs/1503.02531">aquí</a>.</p>

<h2 id="sobre-lo-aprendido">Sobre lo aprendido</h2>
<p>Uno de los principales conceptos que aprendí en el artículo era el de <em>soft labels</em> y <em>hard labels</em>. Las etiquetas duras son directamente las clases a predecir. Por ejemplo:</p>

\[[0, 1, 0, 0]\]

<p>Donde la posición donde se encuentre el $1$ es la clase correcta a predecir de las cuatro que hay. En el entrenamiento más típico, con una función como la entropía cruzada, lo que se utiliza son etiquetas duras. Esta función solo se centra en maximizar la probabilidad de la clase correcta. No voy a entrar en explicar entropía cruzada, seguramente lo deje para otro <em>post</em>, pero para más información dejo <a href="https://machinelearningmastery.com/cross-entropy-for-machine-learning/">este</a> enlace.</p>

<p>Las etiquetas duras solo nos dicen qué clase es la correcta, pero no aporta mayor información. Podríamos preguntarnos, ¿cómo de similares son las clases? o ¿cuánta incertidumbre hay? Para la función de pérdida es lo mismo confundir a un perro con un lobo, que a un perro con un avión. Claramente no es un error de la misma magnitud y las etiquetas duras no nos transmiten este tipo de información.</p>

<p>Aquí es donde entran las <em>soft labels</em> o etiquetas suaves. Las <em>soft labels</em> son probabilidades generadas, en este caso, por el modelo profesor. Por ejemplo:</p>

\[[0.1, 0.14, 0.7, 0.06]\]

<p>Este tipo de estructura sí permite capturar más información, más allá de si es la clase correcta o no. Aquí las clases incorrectas también aportan su granito de arena. Se pueden interpretar las probabilidades asignadas a las demás clases como una representación de las similitudes aprendidas por el modelo. Por ejemplo, si una imagen de un perro recibe también cierta probabilidad en las clases “lobo” o “zorro”, el modelo está indicando que comparte características visuales con esas categorías.</p>

<p>Hay un detalle importante que me dejé por el camino durante mis primeros experimentos. En la destilación de conocimiento no solemos utilizar directamente las probabilidades producidas por el profesor, sino una versión suavizada de ellas. Para ello se divide el vector de <em>logits</em> entre una temperatura antes de aplicar la función <em>softmax</em>. Cuando $T=1$ obtenemos las probabilidades normales del modelo. Sin embargo, al aumentar la temperatura, la distribución se vuelve más uniforme y aparecen relaciones entre clases que normalmente quedarían ocultas. Por ejemplo, una imagen que el profesor clasifica con un $99\%$ de confianza como “perro” podría transformarse en una distribución más suave donde también aparezcan probabilidades apreciables para “lobo” o “zorro”. Esta información adicional resulta muy valiosa para el estudiante, ya que no solo aprende cuál es la respuesta correcta, sino también qué alternativas considera plausibles el profesor. En mi implementación he aplicado un $T=4$, que suele ser bastante estándar y me ha proporcionado buenos resultados. Las <em>soft labels</em> del modelo profesor albergan la distribución “objetivo” que el modelo estudiante ha de aprender. Para ello se utiliza la anteriormente mencionada divergencia <em>KL</em>.</p>

<p>La combinación de ambos tipos de etiquetas produce lo que podríamos definir como <em>sweet spot</em>, ya que incluimos ambos tipos de codificaciones para que la optimización se nutra. No siempre más es mejor, y por supuesto podríamos usar solo las <em>soft labels</em>, como pensaba que funcionaba la destilación de conocimiento al principio, pero parece que funciona mejor con ambas. Para poder darle más potencia a una que a la otra, controlamos un parámetro $\alpha$, que en mi caso he dejado en $50\%$ para darle igual fuerza a las codificaciones duras que a las suaves en la función de pérdida. La función en <em>Python</em> es la que sigue:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">distillation_loss</span><span class="p">(</span><span class="n">student_logits</span><span class="p">,</span> <span class="n">teacher_logits</span><span class="p">,</span> <span class="n">labels</span><span class="p">,</span> <span class="n">T</span><span class="o">=</span><span class="mi">4</span><span class="p">,</span> <span class="n">alpha</span><span class="o">=</span><span class="mf">0.5</span><span class="p">):</span>
    <span class="n">soft_student</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="n">log_softmax</span><span class="p">(</span><span class="n">student_logits</span> <span class="o">/</span> <span class="n">T</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">soft_teacher</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="n">softmax</span><span class="p">(</span><span class="n">teacher_logits</span> <span class="o">/</span> <span class="n">T</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">kl</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="n">kl_div</span><span class="p">(</span><span class="n">soft_student</span><span class="p">,</span> <span class="n">soft_teacher</span><span class="p">,</span> <span class="n">reduction</span><span class="o">=</span><span class="s">"batchmean"</span><span class="p">)</span>
    <span class="n">ce</span> <span class="o">=</span> <span class="n">F</span><span class="p">.</span><span class="n">cross_entropy</span><span class="p">(</span><span class="n">student_logits</span><span class="p">,</span> <span class="n">labels</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">alpha</span> <span class="o">*</span> <span class="n">ce</span> <span class="o">+</span> <span class="p">(</span><span class="mi">1</span> <span class="o">-</span> <span class="n">alpha</span><span class="p">)</span> <span class="o">*</span> <span class="p">(</span><span class="n">T</span> <span class="o">*</span> <span class="n">T</span><span class="p">)</span> <span class="o">*</span> <span class="n">kl</span>
</code></pre></div></div>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/el-aprendiz-y-el-maestro-como-comprimir-inteligencia/loss-ts.png" alt="Proceso de entrenamiento con *knowledge distillation.*" width="600" class="center" />
  <figcaption class="center">Proceso de entrenamiento con *knowledge distillation.*</figcaption>
</figure>

<p>Otra cosa que he tenido que afinar al máximo es el rendimiento del modelo profesor. Al principio probé con un modelo grande y sencillo, sin muchas complicaciones, pero si el modelo es grande, es posible que necesitemos ajustar todo el <em>pipeline</em> de entrenamiento al máximo para poder sacarle rendimiento y huir del temido sobreajuste. En mi caso, apliqué aumentaciones de datos sobre las imágenes (cortes aleatorios sobre la imagen y giros horizontales). Estas técnicas permiten que la red observe distintos ángulos y versiones de la misma imagen, mejorando la capacidad de generalización. También se normalizaron los datos y se aplicó <em>early stopping</em> para poder parar el entrenamiento cuando la red dejase de mejorar. Por supuesto, esto también ha de hacerse con los modelos estudiantes.</p>

<h2 id="resultados-obtenidos">Resultados obtenidos</h2>
<p>Para evaluar los resultados y comparar el modelo que usa destilación de conocimiento frente al que no, presento un par de métricas importantes. Estas son la compresión y la eficiencia:</p>

\[\text{compression} = \frac{\text{teacher_params}}{\text{params}}\]

\[\text{efficiency} = \text{acc} \times \text{compression}\]

<p>La compresión simplemente nos muestra cómo de mucho se ha vuelto el modelo frente al original o profesor. A más grande, más pequeño es el modelo estudiante, menos parámetros. La eficiencia es un ratio entre la precisión y la compresión. Esta última es la más interesante y comparable, ya que permite ver si un modelo es bueno en dos dimensiones distintas. Es interesante reducir mucho el modelo y alcanzar una compresión lo más alta posible, pero si la precisión se ve afectada demasiado, quizá ya no merezca la pena seguir reduciendo. De otra forma, si la precisión se va conservando, quizá sea interesante seguir reduciendo el número de parámetros para obtener un modelo más eficiente.</p>

<p>Tras entrenar al profesor y a los estudiantes, se obtuvieron los siguientes resultados:</p>

<table>
  <thead>
    <tr>
      <th style="text-align: center">Model</th>
      <th style="text-align: center">Acc (test)</th>
      <th style="text-align: center">Params</th>
      <th style="text-align: center">Compression</th>
      <th style="text-align: center">Efficiency</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: center">Teacher</td>
      <td style="text-align: center">0.8865</td>
      <td style="text-align: center">23,528,522</td>
      <td style="text-align: center">1.0×</td>
      <td style="text-align: center">0.886</td>
    </tr>
    <tr>
      <td style="text-align: center">Student baseline</td>
      <td style="text-align: center">0.8169</td>
      <td style="text-align: center">373,386</td>
      <td style="text-align: center">63.0×</td>
      <td style="text-align: center">51.476</td>
    </tr>
    <tr>
      <td style="text-align: center">Student distilled</td>
      <td style="text-align: center">0.8688</td>
      <td style="text-align: center">373,386</td>
      <td style="text-align: center">63.0×</td>
      <td style="text-align: center">54.747</td>
    </tr>
  </tbody>
</table>

<p>De base, el modelo más grande obtiene un $88\%$ de precisión con $23$ millones de parámetros. Obviamente la compresión es de $1.0$ ya que es el modelo de referencia. En el caso de los modelos estudiantes (aunque en realidad uno no es estudiante de nada, se ha entrenado solito sin profesor jeje) se obtienen ratios de compresión iguales, ya que ambos tienen la misma cantidad de parámetros. Lo interesante se observa en la métrica de <em>accuracy</em> y de eficiencia. El estudiante que usó la técnica de destilación de conocimiento, alcanzó un $5\%$ más de precisión que la red neuronal que se entrenó de forma tradicional. De esta forma, la eficiencia es $3$ puntos superior a la del modelo sin destilación.</p>

<p>Este es un caso sencillo, con redes que ya de base funcionan muy bien. Quizá podría haberse entrenado aún mejor al modelo profesor, o se podría haber utilizado un conjunto de datos más complicado para aprovechar mejor esas neuronas extra. Pese a ello pueden observarse los resultados.</p>

<p>Nunca había probado a implementar esta técnica, y para ser sinceros, pensaba que sería mucho más sorprendente. Después de leer un poco de literatura al respecto, depende mucho del ámbito y se aprovecha mejor en entrenamientos mucho más grandes, como los que sufren los modelos de lenguaje actuales. Además, la mejora esperada suele ser leve, de un $2\%$ o $5\%$. Esta técnica es muy usada para la compresión de modelos, sin restringir sus capacidades y partiendo de modelos inmensos y probablemente altamente sobreajustados, pero claro, ¿qué es el sobreajuste cuando puedes sobreajustar el universo?. Si bien se ha hecho muy popular estos últimos años para <strong>LLMs</strong>, creo que hay mejores opciones para otros ámbitos fuera del lenguaje, como el <em>pruning</em> o la cuantización. Pese a ello, siempre es interesante probarlo, compararlo y saber cuándo utilizarlo si se requiere.</p>]]></content><author><name></name></author><category term="redes neuronales" /><category term="neural network" /><category term="kl" /><category term="kullback-leibler" /><category term="teacher" /><category term="student" /><category term="deep learning" /><category term="python" /><category term="cifar" /><category term="torch" /><category term="knowledge distillation" /><summary type="html"><![CDATA[En el deep learning existen multitud de técnicas muy pintorescas, en este post explico una de ellas, la transferencia de conocimiento mediante la técnica de teacher-student. Este método imita un tipo de aprendizaje, por imitación al profesor, el cual sabe ya mucho e intenta transferir ese conocimiento a sus estudiantes. Pero quizá no sea tan revolucionaria como parece...]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://migue8gl.dev/assets/images/el-aprendiz-y-el-maestro-como-comprimir-inteligencia/teacher-student.png" /><media:content medium="image" url="https://migue8gl.dev/assets/images/el-aprendiz-y-el-maestro-como-comprimir-inteligencia/teacher-student.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">¿Sabe una red neuronal lo que no sabe?</title><link href="https://migue8gl.dev/2026/04/24/sabe-una-red-neuronal-lo-que-no-sabe.html" rel="alternate" type="text/html" title="¿Sabe una red neuronal lo que no sabe?" /><published>2026-04-24T00:00:00+00:00</published><updated>2026-04-24T00:00:00+00:00</updated><id>https://migue8gl.dev/2026/04/24/sabe-una-red-neuronal-lo-que-no-sabe</id><content type="html" xml:base="https://migue8gl.dev/2026/04/24/sabe-una-red-neuronal-lo-que-no-sabe.html"><![CDATA[<h2 id="sabe-la-ia-lo-que-no-sabe">¿Sabe la IA lo que no sabe?</h2>
<p>Cuando nos preguntamos si una <strong>IA</strong> es capaz de reconocer aquello que no conoce, ¿a qué nos estamos refiriendo? Ya hemos visto en el <em>post</em> de <a href="/2026/02/14/la-geometria-del-perceptron">la geometría del Perceptrón</a> cómo comenzó el desarrollo de redes neuronales, inspirados en cómo funcionan las neuronas (de forma simplificada al menos). Con el paso del tiempo se fueron desarrollando redes más y más complejas, capaces de aprender patrones sutiles, mejores en tareas varias como el reconocimiento de voz, segmentación de objetos en imágenes, reconocimiento de objetos, clasificación, etc.</p>

<p>La <em>IA</em> basada en redes neuronales es muy potente y flexible, pero también puede ser un poco como una caja negra. Es difícil analizarla y dar respuestas simples a preguntas acerca de su comportamiento. Muchas veces es necesario prescindir de ellas por razones de seguridad, ya que métodos más fáciles de explicar e interpretables son obligatorios en ciertos sectores con alta regulación o en los que simplemente se prima ese factor por encima de la potencia. Volviendo a la pregunta, ¿sabe la <em>IA</em> lo que no sabe? Esta pregunta entraña un tema muy profundo, altamente estudiado y que todavía no está resuelto en su totalidad.</p>

<p>Cuando una red neuronal aprende, esta ajusta sus parámetros internos para minimizar una función de pérdida concreta. En la tarea de clasificación de imágenes, lo que sus parámetros ajustan es la discriminación máxima entre distintas clases de imágenes, por ejemplo reconocer gatos y perros. ¿Qué pasará cuando la red neuronal se vea expuesta a un tipo de dato distinto? Ya no obtendrá como entrada la foto de un perro o un gato, sino la de un tigre. ¿Qué respuesta dará la <em>IA</em> frente a esta situación totalmente nueva? Pues si no se hace nada al respecto, lo único que puede hacer la red es dar las probabilidades de que sea un gato o un perro (probablemente tienda a creer que es un gato).</p>

<p>La respuesta a esta pregunta es clara. La red neuronal no sabe lo que no sabe, es decir, no es capaz de ver un dato y discernir si es un nuevo concepto, algo que no ha visto nunca durante su entrenamiento.</p>

<p>Aquí es donde se conecta directamente con el problema de las cajas negras y la seguridad. No solo es difícil entender por qué un modelo toma una decisión, sino que además puede hacerlo con una confianza injustificada incluso cuando está completamente fuera de su ámbito de conocimiento. Este comportamiento es especialmente problemático en sistemas críticos. No detectar que un dato es desconocido implica que el modelo seguirá produciendo predicciones como si todo fuese normal</p>

<p>Durante la etapa de entrenamiento de la red neuronal, los datos provienen de una distribución concreta. Se establece previamente qué tarea va a resolver y eso tiene asociado unos datos concretos, posiblemente no completos. Se presupone que los datos de <em>test</em>, con los que evaluamos la red neuronal tras el entrenamiento, son ejemplos que provienen de la misma distribución. Estos datos nunca han sido vistos durante el entrenamiento, pero eso no significa que tengan una distribución distinta, si entrenamos con gatos y perros no podemos pretender que sepa que es un coche, ¿me explico? La detección de este tipo de datos que la red neuronal no conoce es lo que se llama detección de <strong>Out-of-Distribution</strong>, a partir de ahora abreviado como <strong>OOD</strong>.</p>

<h3 id="por-qué-queremos-saber-cuando-un-dato-no-pertenece-a-la-distribución-de-entrenamiento">¿Por qué queremos saber cuando un dato no pertenece a la distribución de entrenamiento?</h3>
<p>La fiabilidad en un sistema es un factor clave al que hay que prestar atención, y muchas veces, reconocer datos anómalos o no conocidos es necesario para suplir esta necesidad. Las técnicas de aprendizaje automático han avanzado muchísimo bajo la asunción de un <em>mundo cerrado</em>. Pese a ello, en los problemas del mundo real, estos sistemas se ven expuestos a datos que inevitablemente no pertenecen a la misma distribución que los utilizados durante el entrenamiento de estos modelos. Este tipo de datos son los ya mencionados <em>OOD</em>. Estas muestras pueden ser peligrosas ya que los modelos, al no saber identificar este tipo de problemas, asignan predicciones sobreconfiadas a datos que deberían rechazarse en primer lugar. Esto da lugar a sistemas vulnerables a ataques adversarios, a fallos silenciosos en producción y, en última instancia, a una pérdida de confianza en la tecnología por parte de los usuarios finales.</p>

<p>Existen numerosos métodos que tratan de solucionar este problema desde distintas dimensiones, la elección de uno u otro o todos ellos depende del contexto. ¿Se requiere un modelo que vaya incorporando nueva información con el tiempo según aparezca? Estamos entonces en el campo del <em>online learning</em>, donde el modelo se reentrena o utiliza otras técnicas para actualizar la hipótesis inicial. ¿Queremos detectar si un dato es raro para tratarlo posteriormente? Entonces podemos aplicar detección de <em>OOD</em>.</p>

<p>Un ejemplo claro de donde es crucial que un sistema incorpore este tipo de métodos es en el médico. Un modelo que no pueda detectar muestras <em>OOD</em> juzgará erróneamente enfermedades desconocidas y causará graves diagnósticos erróneos, ya que las clasificará como otro tipo de enfermedad que sí conoce.</p>

<h2 id="detección-por-la-probabilidad-softmax">Detección por la probabilidad <em>Softmax</em></h2>
<p>El método más simple posible para detectar cuando una entrada a la red es <em>OOD</em> es el de <a href="https://arxiv.org/abs/1610.02136">Maximum Softmax Probability</a> o <strong>MSP</strong>. Las redes neuronales necesitan pasar de los <em>logits</em> que producen las capas finales a una distribución de probabilidad. Para ello suelen utilizar la función <em>softmax</em>:</p>

\[\sigma(z)_i=\frac{e^{z_i}}{\sum_{j=1}^Ne^{z_j}}\]

<p>Esta función transforma ese vector final a un vector acotado entre $[0,1]$ y cuyos componentes sumen $1$, de forma que puede interpretarse como una distribución de probabilidad. Cada componente de ese vector final representa la probabilidad que tiene el dato de pertenecer a la clase $i$.</p>

<p>Este método se basa en la prueba empírica de que las redes neuronales tienden a producir una probabilidad máxima alta (de las probabilidades que hay, la más alta suele ser MUY alta en comparación al resto). Esto intuitivamente lo que nos viene a decir es que la red “conoce” ese ejemplo y por tanto se siente “confiada”. En los datos anómalos, fuera de distribución, las probabilidades suelen ser mucho más uniformes. Por tanto se define <em>MSP</em> como:</p>

\[MSP(x)=max_{k}P(y=k|x)\]

<p>Es un método simple. Por supuesto hay mucho más, y más complejos, pero para ilustrar el problema de detección de <em>OOD</em> creo que es el mejor.</p>

<h2 id="ejemplo-con-código">Ejemplo con código</h2>
<p>Para ilustrar mejor el problema voy a escribir unas pocas líneas en <em>Python</em>, empezando por una red convolucional simple.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">ConvNet</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">in_channels</span><span class="p">:</span> <span class="nb">int</span><span class="p">,</span> <span class="n">hidden_units</span><span class="p">:</span> <span class="nb">int</span><span class="p">,</span> <span class="n">output_channels</span><span class="p">:</span> <span class="nb">int</span><span class="p">):</span>
        <span class="nb">super</span><span class="p">().</span><span class="n">__init__</span><span class="p">()</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">block_1</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="n">Sequential</span><span class="p">(</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">Conv2d</span><span class="p">(</span>
                <span class="n">in_channels</span><span class="o">=</span><span class="n">in_channels</span><span class="p">,</span>
                <span class="n">out_channels</span><span class="o">=</span><span class="n">hidden_units</span><span class="p">,</span>
                <span class="n">kernel_size</span><span class="o">=</span><span class="mi">3</span><span class="p">,</span>
                <span class="n">stride</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span>
                <span class="n">padding</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span>
            <span class="p">),</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">ReLU</span><span class="p">(),</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">Conv2d</span><span class="p">(</span>
                <span class="n">in_channels</span><span class="o">=</span><span class="n">hidden_units</span><span class="p">,</span>
                <span class="n">out_channels</span><span class="o">=</span><span class="n">hidden_units</span><span class="p">,</span>
                <span class="n">kernel_size</span><span class="o">=</span><span class="mi">3</span><span class="p">,</span>
                <span class="n">stride</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span>
                <span class="n">padding</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span>
            <span class="p">),</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">ReLU</span><span class="p">(),</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">MaxPool2d</span><span class="p">(</span><span class="n">kernel_size</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span> <span class="n">stride</span><span class="o">=</span><span class="mi">2</span><span class="p">),</span>
        <span class="p">)</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">block_2</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="n">Sequential</span><span class="p">(</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">Conv2d</span><span class="p">(</span><span class="n">hidden_units</span><span class="p">,</span> <span class="n">hidden_units</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="mi">1</span><span class="p">),</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">ReLU</span><span class="p">(),</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">Conv2d</span><span class="p">(</span><span class="n">hidden_units</span><span class="p">,</span> <span class="n">hidden_units</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="mi">1</span><span class="p">),</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">ReLU</span><span class="p">(),</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">MaxPool2d</span><span class="p">(</span><span class="mi">2</span><span class="p">),</span>
        <span class="p">)</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">classifier</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="n">Sequential</span><span class="p">(</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">Flatten</span><span class="p">(),</span>
            <span class="n">nn</span><span class="p">.</span><span class="n">Linear</span><span class="p">(</span><span class="n">in_features</span><span class="o">=</span><span class="n">hidden_units</span> <span class="o">*</span> <span class="mi">7</span> <span class="o">*</span> <span class="mi">7</span><span class="p">,</span> <span class="n">out_features</span><span class="o">=</span><span class="n">output_channels</span><span class="p">),</span>
        <span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">x</span><span class="p">:</span> <span class="n">torch</span><span class="p">.</span><span class="n">Tensor</span><span class="p">):</span>
        <span class="n">x</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">block_1</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
        <span class="n">x</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">block_2</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
        <span class="n">x</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">classifier</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">x</span>
</code></pre></div></div>

<p>Esta red va a ser entrenada con el conjunto de datos de <strong>FashionMNIST</strong>, donde se representan varios tipos de prendas en imágenes de tamaño $28\times 28$ en escala de grises.</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/sabe-una-red-neuronal-lo-que-no-sabe/fashion.png" alt="Datos provenientes del conjunto de FashionMNIST" width="600" class="center" />
  <figcaption class="center">Datos provenientes del conjunto de FashionMNIST</figcaption>
</figure>

<p>Procedemos a entrenar esta red unas pocas épocas y guardamos el modelo. Este modelo solo conoce datos de este conjunto y es capaz, según la partición de <em>test</em>, de clasificar con un $90\%$ de precisión cualquier otro tipo de imagen de prenda que le venga.</p>

<h3 id="msp-en-python">MSP en Python</h3>
<p>El código para calcular los <em>scores</em> de <em>MSP</em> es el siguiente:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">compute_msp</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">loader</span><span class="p">,</span> <span class="n">device</span><span class="p">):</span>
    <span class="n">all_msp</span> <span class="o">=</span> <span class="p">[]</span>

    <span class="k">with</span> <span class="n">torch</span><span class="p">.</span><span class="n">inference_mode</span><span class="p">():</span>
        <span class="k">for</span> <span class="n">X</span><span class="p">,</span> <span class="n">_</span> <span class="ow">in</span> <span class="n">loader</span><span class="p">:</span>
            <span class="n">X</span> <span class="o">=</span> <span class="n">X</span><span class="p">.</span><span class="n">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
            <span class="n">logits</span> <span class="o">=</span> <span class="n">model</span><span class="p">(</span><span class="n">X</span><span class="p">)</span>
            <span class="n">probs</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">softmax</span><span class="p">(</span><span class="n">logits</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
            <span class="n">msp</span> <span class="o">=</span> <span class="n">probs</span><span class="p">.</span><span class="nb">max</span><span class="p">(</span><span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">).</span><span class="n">values</span> 
            <span class="n">all_msp</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">msp</span><span class="p">.</span><span class="n">cpu</span><span class="p">())</span>

    <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="n">cat</span><span class="p">(</span><span class="n">all_msp</span><span class="p">)</span>
</code></pre></div></div>

<p>El modelo lo que devuelve en su capa final son los conocidos <em>logits</em> (hay métodos que trabajan directamente en este punto). Los <em>logits</em>, sin entrar en definiciones matemáticas que se extienden más allá de lo que quiere abarcar este <em>post</em>, son valores en bruto que produce la última capa de la red. La función de pérdida espera probabilidades, por ello deben ser transformados. Ahora lo que hay que hacer es pasarlo por la función <em>softmax</em>.</p>

<p>Ahora vamos a cargar los ejemplos fuera de distribución, los <em>OOD</em> y los ejemplos dentro de distribución, los <em>in-distribution</em> o <strong>ID</strong>,  (ojo, los <em>ID</em> son ejemplos que nunca ha visto, pero sí están dentro de lo que debería conocer la red). Si el detector funciona bien, debería asignar <em>scores</em> mucho más altos a los datos <em>ID</em>.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">id_test</span> <span class="o">=</span> <span class="n">datasets</span><span class="p">.</span><span class="n">FashionMNIST</span><span class="p">(</span>
        <span class="n">root</span><span class="o">=</span><span class="n">data_dir</span><span class="p">,</span>
        <span class="n">train</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span>
        <span class="n">download</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
        <span class="n">transform</span><span class="o">=</span><span class="n">ToTensor</span><span class="p">(),</span>
    <span class="p">)</span>

    <span class="n">ood_test</span> <span class="o">=</span> <span class="n">datasets</span><span class="p">.</span><span class="n">CIFAR10</span><span class="p">(</span>
        <span class="n">root</span><span class="o">=</span><span class="n">data_dir</span><span class="p">,</span>
        <span class="n">train</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span>
        <span class="n">download</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
        <span class="n">transform</span><span class="o">=</span><span class="n">transforms</span><span class="p">.</span><span class="n">Compose</span><span class="p">(</span>
            <span class="p">[</span>
                <span class="n">transforms</span><span class="p">.</span><span class="n">Grayscale</span><span class="p">(</span><span class="n">num_output_channels</span><span class="o">=</span><span class="mi">1</span><span class="p">),</span>
                <span class="n">transforms</span><span class="p">.</span><span class="n">Resize</span><span class="p">((</span><span class="mi">28</span><span class="p">,</span> <span class="mi">28</span><span class="p">)),</span>
                <span class="n">transforms</span><span class="p">.</span><span class="n">ToTensor</span><span class="p">(),</span>
            <span class="p">]</span>
        <span class="p">),</span>
    <span class="p">)</span>
</code></pre></div></div>

<p>Ahora calculamos el valor <strong>AUROC</strong>. Para quien no lo sepa, es una muy buena forma de medir el rendimiento del detector. Para entenderlo, primero hay que entender la curva <em>ROC</em>. Si fijamos un umbral y clasificamos como <em>ID</em> todo lo que lo supere, obtenemos una tasa de muestras <em>ID</em> correctamente detectadas y una tasa de muestras <em>OOD</em> coladas por error. Si vamos moviendo ese umbral de $0$ a $1$, cada posición nos da un par de valores distinto, y la curva <em>ROC</em> es el trazado de todos esos pares.</p>

<p>El <em>AUROC</em> es el área bajo esa curva. Es la probabilidad de que, tomando una muestra <em>ID</em> y una <em>OOD</em> al azar, el modelo asigne una puntuación de confianza más alta a la <em>ID</em>. La gracia es que, al agregar todos los umbrales posibles a la vez, no nos comprometemos con ninguno en concreto (podemos medir cómo de bien funciona el detector tanto si queremos mayor sensibilidad como si preferimos un modelo más equilibrado).</p>

<p>Un valor de $1$ indica separación perfecta entre ambas distribuciones, mientras que $0.5$ equivale a un clasificador aleatorio, es decir, el modelo no tiene ninguna capacidad discriminativa real.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">msp_id</span> <span class="o">=</span> <span class="n">compute_msp</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">id_loader</span><span class="p">,</span> <span class="n">device</span><span class="p">)</span>
<span class="n">msp_ood</span> <span class="o">=</span> <span class="n">compute_msp</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">ood_loader</span><span class="p">,</span> <span class="n">device</span><span class="p">)</span>

<span class="n">scores</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">cat</span><span class="p">([</span><span class="n">msp_id</span><span class="p">,</span> <span class="n">msp_ood</span><span class="p">]).</span><span class="n">numpy</span><span class="p">()</span>
<span class="n">labels</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">cat</span><span class="p">([</span><span class="n">torch</span><span class="p">.</span><span class="n">ones_like</span><span class="p">(</span><span class="n">msp_id</span><span class="p">),</span> <span class="n">torch</span><span class="p">.</span><span class="n">zeros_like</span><span class="p">(</span><span class="n">msp_ood</span><span class="p">)]).</span><span class="n">numpy</span><span class="p">()</span>

<span class="n">auroc</span> <span class="o">=</span> <span class="n">roc_auc_score</span><span class="p">(</span><span class="n">labels</span><span class="p">,</span> <span class="n">scores</span><span class="p">)</span>
</code></pre></div></div>

<p>Los resultados obtenidos son los siguientes:</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/sabe-una-red-neuronal-lo-que-no-sabe/roc_msp_ood.png" alt="Curva ROC del detector de OOD" width="600" class="center" />
  <figcaption class="center">Curva ROC del detector de OOD</figcaption>
</figure>

<p>Como puede observarse, la detección con <em>MSP</em> es bastante buena, llegando a un valor de $0.9$. Si quisiéramos, por contexto del negocio, detectar el $90\%$ de los datos <em>OOD</em>, sería tan sencillo como mover el umbral de probabilidad a partir del cual se decide. Con ello, al medir <em>AUROC</em> para ese punto, veríamos que el ratio de falsos positivos ha aumentado. Por ello, dependiendo del contexto, hay que balancear siempre entre <em>TPR</em> y <em>FPR</em>.</p>

<p>Si visualizamos los <em>scores</em> que produce la función para datos <em>OOD</em> y para datos <em>ID</em> obtenemos lo siguiente:</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/sabe-una-red-neuronal-lo-que-no-sabe/msp_ood_vs_id.png" alt="Distribución de scores MSP" width="600" class="center" />
  <figcaption class="center">Distribución de scores MSP</figcaption>
</figure>

<p>Efectivamente, hay una separación clara, con un poco de solapamiento. La red no es tan confiada con los datos <em>OOD</em> y por ello la distribución de probabilidades que les asigna es prácticamente uniforme. Por el contrario en datos dentro de distribución la máxima probabilidad es muy alta. Esta separación es una huella que aprovechamos para discriminar.</p>

<h2 id="otros-métodos">Otros métodos</h2>
<p>Lo bueno que tienen métodos como <em>MSP</em> es que son agnósticos a la red. Puedes incluirlos en cualquier red neuronal ya entrenada y funcionará. Obviamente es un método muy simple, y sufre de muchos fallos que hacen que no sea el ideal hoy en día, pero para casos sencillos funciona bien. Para quien se haya quedado con ganas de más, recomiendo echar un ojo a la librería <a href="https://github.com/kkirchheim/pytorch-ood">pytorch-ood</a>. Posee una colección de métodos para detección <em>OOD</em>, así como muchas más técnicas y <em>datasets</em> claves para este problema. Merece mucho la pena.</p>]]></content><author><name></name></author><category term="redes neuronales" /><category term="neural network" /><category term="ood" /><category term="ood detection" /><category term="anomalías" /><category term="seguridad" /><category term="deep learning" /><category term="python" /><category term="msp" /><category term="security" /><category term="out of distribution" /><summary type="html"><![CDATA[En este post expongo una pregunta que podría parecer simple, pero nada más lejos de la realidad. ¿Sabe una red neuronal lo que no sabe? Pues en principio no. Necesitaremos métodos externos que se aprovechen de cierta información que tiene la red neuronal, pero incluso así, quizá no sea perfecto. Pero todo esto, ¿para qué sirve? A lo largo del post quedará respondido de forma simple y entendible.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://migue8gl.dev/assets/images/sabe-una-red-neuronal-lo-que-no-sabe/msp_ood_vs_id.png" /><media:content medium="image" url="https://migue8gl.dev/assets/images/sabe-una-red-neuronal-lo-que-no-sabe/msp_ood_vs_id.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">La navaja de Ockham en inversión</title><link href="https://migue8gl.dev/2026/03/21/la-navaja-de-ockham-en-inversion.html" rel="alternate" type="text/html" title="La navaja de Ockham en inversión" /><published>2026-03-21T00:00:00+00:00</published><updated>2026-03-21T00:00:00+00:00</updated><id>https://migue8gl.dev/2026/03/21/la-navaja-de-ockham-en-inversion</id><content type="html" xml:base="https://migue8gl.dev/2026/03/21/la-navaja-de-ockham-en-inversion.html"><![CDATA[<h2 id="mis-primeros-pasos">Mis primeros pasos</h2>

<p>Hace ya unos cuantos años, empecé a interesarme por la inversión. Quería capitalizar mis ahorros. Por ello comencé a investigar cuáles eran las mejores formas de invertir lo que en el momento era mi primer sueldo como ingeniero informático. No tardé mucho hasta encontrar el término de fondo indexado, así como algunas entidades que permitían comprarlos (bancos tradicionales, neobancos, <em>roboadvisors</em>, etc). Incluso le pregunté a un buen amigo mío que estudió economía que qué era lo mejor (saludos Miguelito). Por aquel entonces me recomendó “El pequeño libro de cómo invertir con sentido común”, de John C. Bogle, el creador del primer fondo indexado. Lo compré, lo leí un poco y lo dejé. Demasiados términos que por entonces me costaban entender y quizá poco interés por el tema. Finalmente decidí ir por la vía audiovisual y forera para intentar informarme lo mejor posible. Finalmente me decidí por <strong>Indexa Capital</strong>, un <em>roboadvisor</em> de renombre y de reputación impecable. Para quienes no lo sepan, un <em>roboadvisor</em> no es más que un gestor automático de inversiones, con nula o casi nula intervención humana, lo que da lugar a costes muy bajos. Lo elegí entre otros por su simpleza, su gestión automática y su reputación, pero he de decir que me quedé por su honestidad, educación en el proceso del usuario y fácil entendimiento de la <em>app</em>. Pero bueno, esto no es un anuncio de Indexa. Lo que quiero expresar es que empecé a invertir en fondos indexados y no leí el libro hasta ahora, y la verdad, es que me alegro. Este proceso más lento, de ir aprendiendo por mi cuenta, ha hecho que me empiece a interesar el área de la inversión y la economía como nunca antes lo había hecho. Gracias a ello he conseguido llegar hoy con un entendimiento básico, pero suficiente, como para entender ciertos conceptos del libro, y lo más importante, con interés real sobre la materia. No me entendáis mal, no es un libro complicado, pero si algo no te interesa, lo digieres peor.</p>

<h2 id="ideas-principales-del-libro">Ideas principales del libro</h2>

<p>Para empezar, debería explicar de forma muy resumida algunos conceptos básicos, muy básicos, para poner en contexto a todo el que esté leyendo esto. ¿Qué es un <strong>fondo indexado</strong>? ¿Qué es un <strong>índice</strong>? ¿Qué es una acción? ¿Y un dividendo? ¿Y un fondo de gestión activa? Son muchas cosas, pero las intento explicar rápidamente.</p>

<p>En este mundo en el que vivimos, uno puede beneficiarse de las ganancias que generan las empresas. Podemos <em>capitalizar</em> nuestro dinero comprando una porción de la propiedad de estas empresas, por tanto, tendremos derecho a cobrar una parte de los beneficios generados. Capitalizar se refiere a invertir tu capital (normalmente dinero) con el objetivo de que crezca con el tiempo, ya sea mediante la revalorización de los activos o la generación de ingresos como dividendos. Esas pequeñas porciones de empresas son lo que llamamos acciones. Y aquí es donde entran los dividendos: son la parte de los beneficios que una empresa decide repartir entre sus accionistas. Es decir, si eres dueño de acciones de una empresa que obtiene ganancias, es posible que recibas una pequeña cantidad de dinero de forma periódica simplemente por ser propietario de una parte de ella.</p>

<p>¿Cuál es el problema? Comprar acciones individuales de empresas es como buscar una aguja en un pajar. Si quieres beneficiarte de buenas rentabilidades, ya puedes buscar bien entre miles de empresas y seleccionar tu caballo ganador. Aplicando la navaja de <em>Ockham</em> hay una solución más sencilla y menos arriesgada, comprarlo todo. Aquí es donde entra el concepto de fondo de inversión, el cual se refiere a un conjunto de acciones de muchas empresas. Los fondos indexados hacen exactamente esto, comprar acciones de un sector, como puede ser el americano o europeo, y lo compran todo en base al índice de referencia. Este índice es un marcador de un sector y su misión es reflejar la evolución conjunta de ese conjunto de empresas, permitiendo entender cómo se comporta una parte del mercado. Si compramos un fondo que replica el <em>Standard &amp; Poor’s 500</em> estaremos invirtiendo en las $500$ empresas de mayor capitalización de Estados Unidos. También podemos comprarlas todas, o incluso comprar un fondo que replique a las mayores empresas de todo el mundo. ¿Qué beneficios tiene hacer esto? Lo primero de todo es que elimina el riesgo de elección. Ya no hay que complicarse la vida eligiendo un caballo ganador. Cómpralo todo, y las bajadas de algunas empresas se promediarán con las subidas de otras. Los fondos indexados eliminan el riesgo de las acciones
individuales, los sectores de mercado, y la selección del gestor. Solo permanece el riesgo de mercado, que ya es suficiente.</p>

<p>Muchas personas prefieren contratar un fondo de gestión activa por medio de un gestor, con el objetivo de intentar superar al mercado, obteniendo rentabilidades superiores a este. Pero esto puede ser problemático. Explicaré primero dos conceptos clave.</p>

<ul>
  <li>
    <p>Rentabilidad de inversión: es la rentabilidad real de un negocio. Se puede estimar de forma sencilla como la suma del crecimiento de sus beneficios y la rentabilidad por dividendo. Es decir, lo que ganas como inversor proviene, por un lado, de que la empresa gane cada vez más dinero y, por otro, de los beneficios que reparte directamente entre los accionistas.</p>
  </li>
  <li>
    <p>Rentabilidad de mercado: es la rentabilidad que obtiene el inversor teniendo en cuenta no solo el negocio, sino también cómo lo valora el mercado. Se puede estimar como la suma del crecimiento de los beneficios, la rentabilidad por dividendo y los cambios en la valoración (<strong>PER</strong>). Es decir, además de lo que gana la empresa y reparte, influye cuánto están dispuestos a pagar los inversores por ella en cada momento.</p>
  </li>
</ul>

<p>El <strong>PER</strong> es el ratio de precio/beneficios, o lo que es lo mismo, lo que están dispuestos a pagar los inversores (número de dólares) por cada dólar de beneficios. El mercado está muy influenciado por las emociones en el muy corto plazo, por ello, al igual que la confianza puede subir y bajar, también lo hacen los ratio <em>PER</em>. Cuando hay más miedo, dominan <em>PER</em> bajos. Cuando la avaricia domina, el <em>PER</em> se incrementa.</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/la-navaja-de-ockham-en-inversion/rentabilidad-inversion-vs-mercado.png" alt="Rentabilidad de inversión vs rentabilidad de mercado. Sacado del `Pequeño libro de cómo invertir con sentido común, de John C. Bogle`." width="1000" class="center" />
  <figcaption class="center">Rentabilidad de inversión vs rentabilidad de mercado. Sacado del `Pequeño libro de cómo invertir con sentido común, de John C. Bogle`.</figcaption>
</figure>

<p>Si observamos la gráfica, las rentabilidades obtenidas durante más de cien años en el mercado son prácticamente idénticas. Lo que el gráfico muestra es que mientras los precios que pagamos por las acciones con frecuencia pierden el vínculo con la realidad de los valores, en el largo plazo, la realidad manda. Y esa realidad es que los beneficios para el inversor provienen principalmente de los fundamentales: el crecimiento de los beneficios y los dividendos. Los movimientos de precios derivados del trading o de cambios en la valoración (como el <em>PER</em>) pueden influir en el corto plazo, pero no son la fuente principal de la rentabilidad a largo plazo.</p>

<p>Y aquí es donde entra en juego uno de los conceptos más poderosos en inversión: el interés compuesto. El interés compuesto es el proceso por el cual los rendimientos que generas se reinvierten y, a su vez, generan nuevos rendimientos. Es decir, no solo ganas dinero sobre tu inversión inicial, sino también sobre las ganancias acumuladas con el tiempo. A largo plazo, este efecto se vuelve exponencial y es el verdadero motor del crecimiento del capital. Pero hay un factor clave que puede frenar este proceso, y este factor son los costes. Cada comisión, por pequeña que parezca, reduce la base sobre la que actúa el interés compuesto (y fue una de las razones por las que no invertí en primer lugar en fondos de bancos tradicionales, tienen costes altísimos). Aunque en el corto plazo pueden parecer irrelevantes, en el largo plazo tienen un impacto enorme. No solo pagas ese coste, sino que pierdes todo el crecimiento futuro que ese dinero podría haber generado. Por ello, minimizar los costes es una de las decisiones más importantes que puede tomar un inversor a largo plazo.</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/la-navaja-de-ockham-en-inversion/compound_interest_chart.png" alt="Gráfica sobre el interés compuesto a lo largo de años." width="1000" class="center" />
  <figcaption class="center">Gráfica sobre el interés compuesto a lo largo de años.</figcaption>
</figure>

<p>Por tanto, y volviendo a la gestión activa. Sabemos que todos esos fondos están compitiendo entre ellos, sabemos que esa gestión incurre en muchos más gastos que una gestión pasiva (gastos del gestor, de los impuestos debidos a la compra/venta de acciones con una mayor rotación de cartera, etc) y sabemos por la gráfica que finalmente, el rendimiento que queda sobre la mesa es el real, el rendimiento de inversión. Por tanto, la inversión activa es un juego de suma cero. Si unos ganan, es porque otros pierden en la misma cantidad bruta. No solo es un juego de suma cero, es que luego los intermediarios quitan parte de la rentabilidad con sus honorarios, por lo que es un juego de suma <strong>negativa</strong>. Como grupo, los inversores de fondos de este tipo están condenados a perder dinero. La gestión indexada se beneficia de unas rentabilidades reales, no del <em>trading</em> guiado por estrategias con más o menos sentido con el objetivo de comprar bajo y vender alto. Además sus costes son infinitamente menores, lo cual importa mucho cuando invertimos a largo plazo.</p>

<p>El libro habla de mucho más y analiza cada detalle, defendiendo con fervor el fondo indexado, pero las ideas principales y más importantes ya han sido aquí descritas. Un resumen de lo más importante a tener en cuenta:</p>

<ul>
  <li>Minimizar los costes de los fondos.</li>
  <li>Mantener una estrategia simple y consistente en el tiempo.</li>
  <li>Diversificar al máximo, evitando depender de una sola empresa o sector.</li>
  <li>Entender que la rentabilidad viene del crecimiento real de las empresas y no de intentar predecir el mercado.</li>
  <li>Pensar siempre a largo plazo.</li>
</ul>

<p>No se trata de ser más listo que el mercado, sino de formar parte de él.</p>]]></content><author><name></name></author><category term="index fund" /><category term="fondos indexados" /><category term="assets" /><category term="inversión" /><category term="bogle" /><category term="vanguard" /><category term="investment" /><category term="money" /><summary type="html"><![CDATA[La inversión es un tema que a priori puede parecer complejo, y lo es, pero para la mayoría de nosotros, un punto de vista simple puede ser la mejor opción y la más sensata.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://migue8gl.dev/assets/images/la-navaja-de-ockham-en-inversion/candle-chart.png" /><media:content medium="image" url="https://migue8gl.dev/assets/images/la-navaja-de-ockham-en-inversion/candle-chart.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">La geometría del Perceptrón</title><link href="https://migue8gl.dev/2026/02/14/la-geometria-del-perceptron.html" rel="alternate" type="text/html" title="La geometría del Perceptrón" /><published>2026-02-14T00:00:00+00:00</published><updated>2026-02-14T00:00:00+00:00</updated><id>https://migue8gl.dev/2026/02/14/la-geometria-del-perceptron</id><content type="html" xml:base="https://migue8gl.dev/2026/02/14/la-geometria-del-perceptron.html"><![CDATA[<h2 id="el-origen-del-aprendizaje">El origen del aprendizaje</h2>

<p>El aprendizaje profundo o <em>deep learning</em> en inglés, es una disciplina que ha traído multitud de avances en todos los aspectos de nuestras vidas. Puede que no lo sepamos y lo demos por hecho, pero TODO hoy en día tiene <strong>“IA”</strong>. Digo inteligencia artificial, porque es una palabra casi desvirtuada y usada para todo desde que redes neuronales complejísimas como <strong>GPT</strong> llegaron a nuestras vidas hace unos pocos años. Pero la IA lleva con nosotros desde siempre. Cuando quieres desbloquear el móvil con la cara, se usa IA. Cuando traducimos de un idioma a otro con <em>DeepL</em> o <em>Google Translator</em>, se usa IA. Cuando se extrae texto a partir de una imagen, se usa IA. Cuando detectan lo que estás diciendo a partir de un audio, se usa IA.</p>

<p>La inteligencia artificial es un conjunto muy grande, como expliqué en <a href="/2025/12/25/de-que-trata-este-blog">mi primer post</a>. Todo lo que he mencionado anteriormente, e incluso casos mucho más simples, usan redes neuronales, que pertenecen al área del aprendizaje profundo. El aprendizaje profundo es a su vez un subconjunto del aprendizaje automático, con la diferencia de que está totalmente especializado en redes neuronales profundas, en su arquitectura y su optimización.</p>

<p>El origen del aprendizaje, de la propia inteligencia artificial, tiene su origen en el año $1943$, concretamente en el paper <a href="https://link.springer.com/article/10.1007/BF02478259">A logical calculus of the ideas immanent in nervous activity</a>. En este paper, se describía por primera vez el concepto de una célula cerebral artificial, un análogo simplificado e inspirado por el comportamiento de las neuronas biológicas. Más tarde, en $1957$, se introduciría el <strong>perceptrón</strong> (<a href="https://websites.umass.edu/brain-wars/1957-the-birth-of-cognitive-science/the-perceptron-a-perceiving-and-recognizing-automaton/">The Perceptron — A Perceiving and Recognizing Automaton</a>).</p>

<p>Un algoritmo con la característica de poder “aprender”.</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/la-geometria-del-perceptron/perceptron.png" alt="Esquema del Perceptron" width="500" class="center" />
  <figcaption class="center">Esquema del Perceptron</figcaption>
</figure>

<p>El <strong>perceptrón</strong> se inspira en cómo funcionan (de forma simplificada) las neuronas biológicas. Estas reciben varias entradas en forma de señales de otras neuronas por las dendritas. Cada señal tiene un peso y la neurona se encarga de sumar todas ellas y procesarlas internamente. Cuando la señal supera un umbral, la neurona manda un impulso eléctrico llamado potencial de acción. Esto es literalmente una onda eléctrica que viaja por el axón y que envía la señal a otras neuronas.</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/la-geometria-del-perceptron/neuron.jpg" alt="Partes de una neurona biológica" width="500" class="center" />
  <figcaption class="center">Partes de una neurona biológica</figcaption>
</figure>

<p>El perceptrón usa esa inspiración y la utiliza para poder aprender. Concretamente, para poder clasificar. El perceptrón es un clasificador lineal binario por naturaleza. El hecho de que sea lineal implica que es capaz de separar los datos únicamente mediante una frontera de decisión lineal. Traza una línea (en dos dimensiones), un plano (en tres dimensiones) o un hiperplano (en dimensiones superiores) que divide el espacio en dos regiones, asignando cada una a una clase distinta.</p>

<h2 id="matemáticas-del-perceptrón">Matemáticas del perceptrón</h2>

<p>Definamos qué es un perceptrón a nivel matemático, de forma sencilla. El perceptrón trabaja como clasificador binario, por tanto se tienen dos clases.</p>

<p>Se define una función de decisión $\sigma(z)$ que combina linealmente las entradas (señales de las dendritas) con un vector de pesos $w$ (la fuerza de cada señal). Los pesos son parámetros que se irán aprendiendo a medida que el algoritmo avance de iteración en iteración:</p>

\[z=w_1x_1+w_2x_2+...+w_nx_n\]

\[\begin{equation}\sigma(z)=\begin{cases}1 &amp; \text{if z} \ge \theta \\ -1 &amp; \text{en otro caso}\end{cases}\end{equation}\]

<p>Si esa combinación supera un umbral, clasifica como $1$, en caso contrario clasifica como $-1$.</p>

<p>Como ese umbral no lo conocemos, podemos integrarlo a la fórmula como otro parámetro más, otra variable aprendible. De esta forma también simplificamos el código:</p>

\[z\ge\theta \hspace{3mm}\rightarrow\hspace{3mm} z-\theta\ge 0\]

<p>Definiendo de esta forma el sesgo o <strong>bias</strong>:</p>

\[b=-\theta\]

<p>Ahora, la combinación lineal quedaría como $z=w_1x_1+w_2x_2+…+w_nx_n + b$, que es, escribiéndolo en forma vectorial, $w^Tx + b$.</p>

<h3 id="por-qué-esas-fórmulas">¿Por qué esas fórmulas?</h3>

<p>Quizá la elección de la fórmula que usa el perceptrón parezca arbitraria, pero nada más alejado de la realidad. Se trata de un clasificador binario, como he mencionado anteriormente. Este clasificador va a tratar de discriminar los puntos del espacio (nuestros datos) en dos regiones. Para ello, ¿qué herramienta matemática nos es más adecuada? A continuación dejo la siguiente imagen:</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/la-geometria-del-perceptron/linear_dataset.png" alt="Conjunto de datos en un espacio 2D" width="500" class="center" />
  <figcaption class="center">Conjunto de datos en un espacio 2D</figcaption>
</figure>

<p>En este sencillo ejemplo hay datos de la clase uno y la clase menos uno. Podrían ser gato y perro, crédito concedido o rechazado, apto o no apto, eso da igual. Lo importante es intentar separarlos de la mejor forma posible y creo no estar muy equivocado ni muy loco si lo intento hacer con una línea recta. Si esto lo extrapolamos al espacio $3D$, es fácil imaginar que la mejor manera (para estos datos que son linealmente separables) es usar un plano. Para todas las dimensiones ocurre lo mismo (asumiendo, y no quiero ser pesado, que son datos linealmente separables). Nuestra frontera de decisión la va a decidir un hiperplano de $N$ dimensiones. La suma ponderada descrita anteriormente coincide con la ecuación del hiperplano en $N$ dimensiones. Para el caso de la recta en el espacio $2D$ es exactamente $w_1x_1+w_2x_2+b=0$, donde el sesgo $b$ es la intersección de la recta con el eje $y$.</p>

<p>La combinación de pesos con entradas es sencilla de entender, igual que la función de clasificación. A la hora de simplificar la fórmula, lo único que hemos hecho es restar el umbral en ambos términos, de forma que $z-\theta$ tiene que ser mayor que cero para clasificar. Así añadimos un parámetro que era desconocido a nuestra fórmula para poder aprenderlo.</p>

<p>En cuanto a la forma vectorial de expresar la combinación de entradas con pesos, recordemos que un vector puede interpretarse como una matriz de una sola fila o de una sola columna. Pongamos que tenemos un vector fila, es decir, tiene dimensiones $1\times N$, donde $N$ es el número de elementos del vector. Si fuese un vector columna, tendría dimensiones $N\times 1$. El nombre columna o fila hace referencia a la forma visual de representarlos: un vector fila se escribe horizontalmente y un vector columna verticalmente.</p>

<p>En el perceptrón solemos considerar $x$ como vector columna de dimensión $N\times 1$ y $w$ también como vector columna de dimensión $N\times 1$. Para poder multiplicarlos y obtener un escalar, transponemos $w$, de forma que $w^T$ pasa a tener dimensión $1\times N$. Así, el producto $w^Tx$ tiene dimensiones $(1\times N)(N\times 1)$ y su resultado es un único valor (un escalar), que coincide con la suma ponderada de las entradas. Finalmente, al añadir el sesgo $b$, obtenemos la expresión completa $z = w^Tx + b$.</p>

<h4 id="multiplicación-paso-a-paso-producto-escalar-con-un-ejemplo-básico">Multiplicación paso a paso (producto escalar) con un ejemplo básico</h4>

<p>Sea:</p>

\[w=\begin{pmatrix} w_1 \\ w_2 \end{pmatrix}, \qquad
x=\begin{pmatrix} x_1 \\ x_2 \end{pmatrix}.\]

<p>Primero transponemos $w$:</p>

\[w^T=\begin{pmatrix} w_1 &amp; w_2 \end{pmatrix}.\]

\[w^Tx=
\begin{pmatrix} w_1 &amp; w_2 \end{pmatrix}
\begin{pmatrix} x_1 \\ x_2 \end{pmatrix}.\]

<p>La regla de multiplicación es “fila por columna”:</p>

\[w^Tx = w_1x_1 + w_2x_2.\]

<p>Si añadimos el sesgo, queda:</p>

\[z = w^Tx + b = w_1x_1 + w_2x_2 + b.\]

<p>De hecho, podemos simplificar aún más la expresión si tratamos al sesgo como un peso extra que multiplica a una entrada fija. Añadamos el sesgo como un peso $w_0$. Para ello el vector de entradas debe tener un elemento correspondiente, para que las matemáticas funcionen. Por eso añadimos $1$ como $x_0$. Ahora $w=[w_0,w_1,\dots,w_n]$ y $x=[1,x_1,\dots,x_n]$. Ahora la combinación lineal es más simple aún:</p>

\[z=w^Tx\]

<h3 id="cómo-aprende-el-perceptrón">¿Cómo aprende el perceptrón?</h3>

<p>Para que el perceptrón aprenda a dividir el espacio en dos, comienza con unos pesos aleatorios y va iterando sobre los datos.<br />
En cada paso busca un punto que esté mal clasificado. Si lo encuentra, ajusta los pesos para corregir ese error.</p>

<p>La regla de actualización es:</p>

\[w_{new} = w_{old} + y_i x_i\]

<p>donde:</p>

<ul>
  <li>$x_i$ es el punto mal clasificado,</li>
  <li>$y_i \in {-1, +1}$ es su etiqueta correcta.</li>
</ul>

<p>Solo se actualiza cuando el punto está mal clasificado, es decir, cuando:</p>

\[y_i (w^T x_i) \le 0\]

<p>Debemos saber que el vector $w$ es <strong>perpendicular</strong> a todos los vectores contenidos en el hiperplano de decisión, o lo que es lo mismo, $w$ es el vector normal del hiperplano. Esto es así ya que el hiperplano está definido por la ecuación:</p>

\[w^T x + b = 0\]

<p>Tomemos dos puntos cualesquiera $x_1$ y $x_2$ que estén sobre el hiperplano. Entonces se cumple:</p>

\[w^T x_1 + b = 0\]

\[w^T x_2 + b = 0\]

<p>Si restamos ambas expresiones obtenemos:</p>

\[w^T (x_1 - x_2) = 0\]

<p>El vector $(x_1 - x_2)$ es un vector contenido en el hiperplano (porque conecta dos puntos del propio plano). Y si el producto escalar entre $w$ y ese vector es cero, significa que son <strong>perpendiculares</strong>. De hecho podríamos incluso sacar el ángulo que forma $w$ con el hiperplano y veríamos que es de $90º$. Geométricamente esto es muy importante ya que cambiar la dirección de $w$ implica rotar el hiperplano. Por tanto, cambiar $w$ significa cambiar la orientación de la frontera que separa las clases.</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/la-geometria-del-perceptron/linear_dataset_solved.png" alt="Hiperplano separador en el espacio 2D y el vector normal de pesos" width="500" class="center" />
  <figcaption class="center">Hiperplano separador en el espacio 2D y el vector normal de pesos</figcaption>
</figure>

<p>La actualización:</p>

\[w_{new} = w_{old} + y_i x_i\]

<p>lo que hace es mover ligeramente el vector $w$ en la dirección necesaria para corregir el error. Veamos los dos casos.</p>

<h4 id="si-el-punto-es-positivo-y_i--1-y-está-mal-clasificado">Si el punto es positivo ($y_i = +1$) y está mal clasificado</h4>

<p>La actualización se convierte en:</p>

\[w_{new} = w_{old} + x_i\]

<p>Estamos sumando el vector del punto a los pesos. Eso hace que $w$ se mueva en dirección hacia ese punto. Como el hiperplano es perpendicular a $w$, la frontera gira ligeramente para intentar dejar ese punto en el lado correcto.</p>

<h4 id="si-el-punto-es-negativo-y_i---1-y-está-mal-clasificado">Si el punto es negativo ($y_i = -1$) y está mal clasificado</h4>

<p>La actualización se convierte en:</p>

\[w_{new} = w_{old} - x_i\]

<p>Ahora estamos restando el vector del punto. Eso mueve $w$ en dirección opuesta al punto negativo, haciendo que la frontera se ajuste para empujarlo al lado correcto.</p>

<p>El perceptrón esconde las matemáticas base que hacen posible aprender. Obviamente los métodos se han perfeccionado iteración tras iteración, pero la base de modelos como <strong>GPT</strong> es nada más y nada menos que esa. Vincular conceptos geométricos como la ecuación del plano y de la recta a modelos de inteligencia artificial tan potentes, capaces de simular el lenguaje humano, hacen explotar muchas cabezas y silenciar muchas bocas que decían: ¿pero para qué sirven estas tonterías que aprendemos en mates?</p>

<p>Dejo finalmente una pequeña simulación hecha por <em>Claude</em> para ver cómo se ajusta la frontera de decisión:</p>

<div style="display: flex; justify-content: center; margin: 2rem 0;">
<iframe src="/assets/demos/perceptron.html" width="70%" height="600" style="border: none; border-radius: 8px;" loading="lazy">
</iframe>
</div>]]></content><author><name></name></author><category term="redes neuronales" /><category term="neural network" /><category term="maths" /><category term="geometry" /><category term="geometría" /><category term="perceptron" /><category term="deep learning" /><category term="python" /><summary type="html"><![CDATA[En este post explico brevemente qué es el Perceptrón, su importancia en el deep learning y su bella geometría. Como a partir de simples reglas es capaz de clasificar puntos de datos en el espacio y cómo este es el origen de algo mucha más grande y potente.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://migue8gl.dev/assets/images/la-geometria-del-perceptron/perceptron.png" /><media:content medium="image" url="https://migue8gl.dev/assets/images/la-geometria-del-perceptron/perceptron.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">El teorema del límite central</title><link href="https://migue8gl.dev/2026/01/24/teorema-del-limite-central.html" rel="alternate" type="text/html" title="El teorema del límite central" /><published>2026-01-24T00:00:00+00:00</published><updated>2026-01-24T00:00:00+00:00</updated><id>https://migue8gl.dev/2026/01/24/teorema-del-limite-central</id><content type="html" xml:base="https://migue8gl.dev/2026/01/24/teorema-del-limite-central.html"><![CDATA[<h2 id="el-teorema-del-límite-central">El teorema del límite central</h2>

<p>El teorema del límite central es una idea clave y muy conveniente en la estadística. Este concepto nos permite extrapolar información a partir de muestras bien seleccionadas sobre la población. Lo que nos dice este teorema es que, si obtenemos distintas muestras para un tamaño muestral suficientemente grande y posteriormente hacemos la media de cada muestra, dichas medias se aproximan a una distribución normal. ¿Qué significa eso? Vayamos por partes. En estadística, una muestra no es más que un subconjunto aleatorio de una población. Una población es un conjunto que contiene todos los individuos, elementos u observaciones posibles. Es decir, imaginemos que queremos obtener la media del sueldo en España para todos los trabajadores en activo.</p>

<p>En este caso, la población recogería a todos los trabajadores de España en activo. Recoger datos de todos ellos resultaría casi imposible y muy costoso en la práctica, por eso es mejor seleccionar aleatoriamente a varios individuos que encajen en este perfil para obtener la información que buscamos. Estos individuos formarían las muestras. Supongamos que tomamos una muestra aleatoria de $50$ trabajadores de toda España. Es posible que, por azar, nuestra muestra incluya más gente de zonas con sueldos altos o bajos, y la media resultante se aleje de la media real. Esa variabilidad es natural. Cada muestra dará un resultado ligeramente distinto. Lo que nos dice el teorema del límite central es cómo se distribuyen esas medias si pudiéramos repetir el muestreo muchas veces. Si nos vamos a la Costa del Sol, seguramente estemos valorando muy positivamente lo que ganan en promedio los españoles. Lo mismo ocurriría en un barrio pobre, donde ahora estaríamos sesgando la métrica hacia abajo.</p>

<p>Es aquí donde el teorema del límite central hace su magia. Si cogemos las muestras y promediamos sus valores, vemos que la distribución estadística que siguen las medias de las muestras es similar a una normal. Cada media muestral es ya un estimador insesgado de la media poblacional. El teorema del límite central nos dice cómo se distribuye ese estimador cuando repetimos el experimento muchas veces. Estaríamos obteniendo información sobre el conjunto completo, pero sin haber tenido que recolectar datos de todos los trabajadores. Pero ojo, es importante que el tamaño muestral (el número de trabajadores a los que preguntamos cada vez) sea suficientemente alto. Depende de lo complicada que sea la distribución de la población, quizá sea necesario un número más alto o más bajo, pero generalmente cuanto más, mejor. De hecho, típicamente se establece el número $30$ como el límite mínimo para que la distribución de las medias empiece a asemejarse a una normal. Pero como he explicado, esto no siempre es así, depende.</p>

<p>Esto nos permite además tener información sobre la incertidumbre, es decir, sobre el error que podríamos estar cometiendo al estimar la media poblacional. Gracias a estar siguiendo una distribución normal, nos podemos someter a sus reglas. Y conocemos muy bien sus reglas.</p>

<h2 id="ejemplo-práctico">Ejemplo práctico</h2>

<p>Simulemos rápidamente en <em>Python</em> el teorema del límite central. La distribución de la población en este caso es uniforme discreta, es decir, vamos a generar números enteros, concretamente entre el $0$ y el $9$, y cada uno de ellos tiene las mismas probabilidades de salir en cada muestra que obtengamos. El código con <em>NumPy</em> quedaría tal que así:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">np</span><span class="p">.</span><span class="n">mean</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randint</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">10</span><span class="p">,</span> <span class="n">sample_size</span><span class="p">))</span>
</code></pre></div></div>

<p>Lo que estamos haciendo es muestrear números enteros de una distribución uniforme. El parámetro <code class="language-plaintext highlighter-rouge">sample_size</code> indica cuantas observaciones tiene la muestra.</p>

<p>Ahora vamos a repetir este muestreo tantas veces como queramos. En este caso un total de $10000$ veces. Si cogemos la media de cada muestra y construimos un vector con ellas, podemos crear un histograma para ver que distribución sigue:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">import</span> <span class="nn">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>
<span class="kn">import</span> <span class="nn">seaborn</span> <span class="k">as</span> <span class="n">sns</span>

<span class="k">def</span> <span class="nf">main</span><span class="p">():</span>
    <span class="n">n_samples</span> <span class="o">=</span> <span class="mi">10000</span>  
    <span class="n">sample_size</span> <span class="o">=</span> <span class="mi">1</span>

    <span class="n">sample_means</span> <span class="o">=</span> <span class="p">[</span>
        <span class="n">np</span><span class="p">.</span><span class="n">mean</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randint</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">10</span><span class="p">,</span> <span class="n">sample_size</span><span class="p">))</span>
        <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">n_samples</span><span class="p">)</span>
    <span class="p">]</span>

    <span class="n">sns</span><span class="p">.</span><span class="n">histplot</span><span class="p">(</span><span class="n">sample_means</span><span class="p">,</span> <span class="n">bins</span><span class="o">=</span><span class="mi">50</span><span class="p">,</span> <span class="n">kde</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
    <span class="n">plt</span><span class="p">.</span><span class="n">title</span><span class="p">(</span><span class="s">"Central Limit Theorem: Distribution of Sample Means"</span><span class="p">)</span>
    <span class="n">plt</span><span class="p">.</span><span class="n">xlabel</span><span class="p">(</span><span class="s">"Sample Mean"</span><span class="p">)</span>
    <span class="n">plt</span><span class="p">.</span><span class="n">ylabel</span><span class="p">(</span><span class="s">"Frequency"</span><span class="p">)</span>
    <span class="n">plt</span><span class="p">.</span><span class="n">savefig</span><span class="p">(</span><span class="sa">f</span><span class="s">"scripts/central_limit_theorem/clt_</span><span class="si">{</span><span class="n">sample_size</span><span class="si">}</span><span class="s">.png"</span><span class="p">)</span>
    <span class="n">plt</span><span class="p">.</span><span class="n">close</span><span class="p">()</span>

<span class="k">if</span> <span class="n">__name__</span> <span class="o">==</span> <span class="s">"__main__"</span><span class="p">:</span>
    <span class="n">main</span><span class="p">()</span>
</code></pre></div></div>

<p>En la siguiente imagen podemos ver, de izquierda a derecha y de arriba a abajo, las distribuciones resultantes. Con solo una observación por muestra, obtenemos la distribución original, en este caso la uniforme. La media de cada muestra es el propio valor, por tanto, cada entero ha salido casi las mismas veces que el resto de enteros. Con un tamaño muestral de dos observaciones ya empieza a tomar una forma acampanada. Si se sigue aumentando el tamaño muestral, la media muestral, que al final es una aproximación a la media poblacional o valor esperado, será cada vez más fiel.</p>

<!-- _includes/image_grid.html -->
<figure class="image-grid">
  <div class="image-row">
    
    
      <img src="/assets/images/teorema-del-limite-central/clt_1.png" alt="Distribución de medias para tamaño muestral 1, 2, 4 y 15" class="grid-image" />


      <img src="/assets/images/teorema-del-limite-central/clt_2.png" alt="Distribución de medias para tamaño muestral 1, 2, 4 y 15" class="grid-image" />
      
      
        </div><div class="image-row">
      
    
      <img src="/assets/images/teorema-del-limite-central/clt_4.png" alt="Distribución de medias para tamaño muestral 1, 2, 4 y 15" class="grid-image" />


      <img src="/assets/images/teorema-del-limite-central/clt_15.png" alt="Distribución de medias para tamaño muestral 1, 2, 4 y 15" class="grid-image" />


  </div>
  <figcaption class="center">Distribución de medias para tamaño muestral 1, 2, 4 y 15</figcaption>
</figure>

<p>Por supuesto podemos seguir incrementando el tamaño muestral, pero concretamente para la distribución original uniforme no tiene mucho sentido. Es una distribución sencilla, por lo que con unas muestras relativamente pequeñas es suficiente para observar la campana de <em>Gauss</em>.</p>

<!-- _includes/image_grid.html -->
<figure class="image-grid">
  <div class="image-row">
    
    
      <img src="/assets/images/teorema-del-limite-central/clt_30.png" alt="Distribución de medias para tamaño muestral 30, 50, 120 y 600" class="grid-image" />


      <img src="/assets/images/teorema-del-limite-central/clt_50.png" alt="Distribución de medias para tamaño muestral 30, 50, 120 y 600" class="grid-image" />
      
      
        </div><div class="image-row">
      
    
      <img src="/assets/images/teorema-del-limite-central/clt_120.png" alt="Distribución de medias para tamaño muestral 30, 50, 120 y 600" class="grid-image" />


      <img src="/assets/images/teorema-del-limite-central/clt_600.png" alt="Distribución de medias para tamaño muestral 30, 50, 120 y 600" class="grid-image" />


  </div>
  <figcaption class="center">Distribución de medias para tamaño muestral 30, 50, 120 y 600</figcaption>
</figure>

<h2 id="qué-podemos-inferir-a-partir-de-todo-esto">¿Qué podemos inferir a partir de todo esto?</h2>

<p>La verdadera potencia del teorema del límite central no está solo en que “aparezca una campana”, sino en todo lo que nos permite inferir a partir de ella. Una vez sabemos que la media muestral sigue (aproximadamente) una distribución normal, podemos empezar a cuantificar la incertidumbre de nuestras estimaciones.</p>

<p>En primer lugar, podemos hablar del <strong>error estándar de la media</strong>, que no es más que la desviación típica de la distribución de las medias muestrales. Este valor nos dice cuánto esperamos que varíe la media muestral alrededor de la media poblacional real. Matemáticamente, este error estándar se define como:</p>

\[\frac{\sigma}{\sqrt{n}}\]

<p>donde \(\sigma\) es la desviación típica de la población y \(n\) el tamaño muestral. Aquí aparece una idea clave: a mayor tamaño muestral, menor incertidumbre. No porque la media “sea mejor” por arte de magia, sino porque estamos reduciendo la variabilidad de nuestro estimador.</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/teorema-del-limite-central/clt_densities_overlay.png" alt="Errores estándar sobre la media" width="1000" class="center" />
  <figcaption class="center">Errores estándar sobre la media</figcaption>
</figure>

<p>Gracias a esto, podemos construir <strong>intervalos de confianza</strong>. Por ejemplo, un intervalo de confianza del $95\%$ nos indica que, si repitiéramos el proceso de muestreo muchas veces, el $95\%$ de los intervalos construidos contendrían la media poblacional verdadera. Intuitivamente, no estamos diciendo que la media sea exactamente un número concreto, sino que estamos bastante seguros de que se encuentra en cierto intervalo alrededor de nuestra estimación.</p>

<p>Por último, todo esto nos recuerda algo importante: no solo importa el valor que estimamos, sino también el error que cometemos al estimarlo. El teorema del límite central nos da un marco matemático sólido para medir esa incertidumbre y tomar decisiones informadas, incluso cuando no conocemos la distribución real de la población.</p>

<p>Este truquito estadístico se usa en multitud de ámbitos y métodos, algunos de ellos muy relacionados con el <em>machine learning</em>, como la fórmula del error cuadrático medio o <strong>MSE</strong>. En un futuro post hablaré de ello y cómo su fórmula se puede explicar y entender mejor gracias a este concepto estadístico.</p>]]></content><author><name></name></author><category term="estadística" /><category term="statistics" /><category term="clt" /><category term="central limit theorem" /><category term="python" /><category term="numpy" /><category term="teorema del límite central" /><summary type="html"><![CDATA[El teorema del límite central es una idea clave de la estadística que describe un fenómeno natural. La distribución de la media muestral, con un tamaño suficientemente grande, sigue una distribución normal, independientemente de la distribución original de la población.]]></summary></entry><entry><title type="html">La magia de la vectorización</title><link href="https://migue8gl.dev/2026/01/06/vectorizacion-en-python.html" rel="alternate" type="text/html" title="La magia de la vectorización" /><published>2026-01-06T00:00:00+00:00</published><updated>2026-01-06T00:00:00+00:00</updated><id>https://migue8gl.dev/2026/01/06/vectorizacion-en-python</id><content type="html" xml:base="https://migue8gl.dev/2026/01/06/vectorizacion-en-python.html"><![CDATA[<h2 id="qué-es-la-vectorización">¿Qué es la vectorización?</h2>

<p>Como programador siempre he tenido en cuenta la eficiencia a la hora de crear sistemas. Los numeritos bajando, indicando poco tiempo de ejecución, nos producen cosquillas en el cerebro. Una forma de conseguir código más veloz es mediante la técnica de vectorización.</p>

<p>¿Qué es la vectorización entonces? Es un método por el cual aplicamos operaciones sobre un conjunto de elementos de forma simultánea, en vez de aplicarlas de una en una. Sencillo de entender y muy fácil de aplicar en <em>Python</em> con la librería de cálculo numérico <em>NumPy</em>.</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/vectorizacion-en-python/vectorization.png" alt="Ejemplo visual de operación vectorizada sobre un conjunto de elementos" width="500" class="center" />
  <figcaption class="center">Ejemplo visual de operación vectorizada sobre un conjunto de elementos</figcaption>
</figure>

<p>Sin embargo, no todos los problemas son vectorizables. Para que una operación pueda vectorizarse, los cálculos sobre cada elemento deben ser independientes entre sí, es decir, el resultado de un elemento no puede depender del resultado de otro. Esto es así porque las operaciones se ejecutan en paralelo. Si existiera dependencia entre los resultados, sería necesario coordinar la ejecución, introduciendo un <em>overhead</em> que reduciría, o incluso anularía, las ventajas en rendimiento.</p>

<p>También es necesario estructurar los datos en <em>arrays</em> o matrices, es decir, estructuras homogéneas. Las <em>GPUs</em> y <em>CPUs</em> están optimizadas para operar bajo estas estructuras. <em>NumPy</em> está programado para aprovechar estas optimizaciones.</p>

<h2 id="vectorización-de-un-ga">Vectorización de un GA</h2>

<p>Como ya vimos en mi anterior <em>post</em> cómo funcionan los <a href="/2025/12/30/algoritmos-geneticos">algoritmos genéticos</a>, podemos aprovechar el código secuencial en <em>Python</em> puro para introducir unas cuantas mejoras. Todos los operadores de ese código son perfectamente vectorizables. Al realizar el cambio, veremos una mejora muy sustancial, ya que los bucles en <em>Python</em> son inherentemente lentos.</p>

<p>Empecemos por el operador de mutación:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">mutate</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">x</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">:</span>
        <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">size</span><span class="p">):</span>
            <span class="k">if</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">rand</span><span class="p">()</span> <span class="o">&lt;</span> <span class="bp">self</span><span class="p">.</span><span class="n">mutation_rate</span><span class="p">:</span>
                <span class="n">x</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="o">=</span> <span class="mi">1</span> <span class="o">-</span> <span class="n">x</span><span class="p">[</span><span class="n">i</span><span class="p">]</span>
        <span class="k">return</span> <span class="n">x</span>
</code></pre></div></div>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">mutate_vectorized</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">population</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">:</span>
        <span class="n">mask</span> <span class="o">=</span> <span class="p">(</span>
            <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">rand</span><span class="p">(</span><span class="n">population</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="n">population</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">])</span>
            <span class="o">&lt;</span> <span class="bp">self</span><span class="p">.</span><span class="n">mutation_rate</span>
        <span class="p">)</span>
        <span class="n">population</span><span class="p">[</span><span class="n">mask</span><span class="p">]</span> <span class="o">=</span> <span class="mi">1</span> <span class="o">-</span> <span class="n">population</span><span class="p">[</span><span class="n">mask</span><span class="p">]</span>
        <span class="k">return</span> <span class="n">population</span>
</code></pre></div></div>

<p>En el primer código usé un <code class="language-plaintext highlighter-rouge">for-loop</code> en <em>Python</em> (extremadamente lento si el conjunto a iterar crece mucho) para ir mutando cada gen uno a uno. Además, se realiza la operación de generación de un número aleatorio individualmente.</p>

<p>En el segundo código creamos una máscara del tamaño de la población total. Véase que aquí operamos no sobre un individuo $x\in X$, sino sobre toda la población $X$. Si el número generado es menor a la probabilidad de mutación, entonces se aplica mutación. Después se aplica, de forma simultánea, la máscara sobre la operación para hacer el cambio de <em>bit</em>.</p>

<p>La diferencia es abismal. Asumamos unos $800$ genes por cromosoma con $50$ cromosomas y $200$ generaciones. En el primer código estaríamos iterando unas $800$ veces por cada individuo (unas $50\times 800=40.000$ iteraciones de un bucle <em>for</em>). Eso multiplicado por $200$ generaciones da unas $8.000.000$ iteraciones totales. En el segundo código se muta a la población de una generación de una sola vez. Pasamos de $8$ millones de iteraciones a unas $200$ operaciones vectoriales masivas.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">crossover</span><span class="p">(</span>
        <span class="bp">self</span><span class="p">,</span> <span class="n">x1</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">,</span> <span class="n">x2</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span>
    <span class="p">)</span> <span class="o">-&gt;</span> <span class="n">Tuple</span><span class="p">[</span><span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">,</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">]:</span>
        <span class="k">if</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">rand</span><span class="p">()</span> <span class="o">&gt;</span> <span class="bp">self</span><span class="p">.</span><span class="n">crossover_rate</span><span class="p">:</span>
            <span class="k">return</span> <span class="n">x1</span><span class="p">.</span><span class="n">copy</span><span class="p">(),</span> <span class="n">x2</span><span class="p">.</span><span class="n">copy</span><span class="p">()</span>
        <span class="n">point</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randint</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">x1</span><span class="p">.</span><span class="n">size</span><span class="p">)</span>
        <span class="n">c1</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">concatenate</span><span class="p">([</span><span class="n">x1</span><span class="p">[:</span><span class="n">point</span><span class="p">],</span> <span class="n">x2</span><span class="p">[</span><span class="n">point</span><span class="p">:]])</span>
        <span class="n">c2</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">concatenate</span><span class="p">([</span><span class="n">x2</span><span class="p">[:</span><span class="n">point</span><span class="p">],</span> <span class="n">x1</span><span class="p">[</span><span class="n">point</span><span class="p">:]])</span>
        <span class="k">return</span> <span class="n">c1</span><span class="p">,</span> <span class="n">c2</span>
</code></pre></div></div>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">crossover_vectorized</span><span class="p">(</span>
        <span class="bp">self</span><span class="p">,</span> <span class="n">population</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">,</span> <span class="n">indices</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span>
    <span class="p">)</span> <span class="o">-&gt;</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">:</span>
        <span class="n">n_pairs</span> <span class="o">=</span> <span class="nb">len</span><span class="p">(</span><span class="n">indices</span><span class="p">)</span> <span class="o">//</span> <span class="mi">2</span>
        <span class="n">parents1</span> <span class="o">=</span> <span class="n">population</span><span class="p">[</span><span class="n">indices</span><span class="p">[::</span><span class="mi">2</span><span class="p">]]</span>
        <span class="n">parents2</span> <span class="o">=</span> <span class="n">population</span><span class="p">[</span><span class="n">indices</span><span class="p">[</span><span class="mi">1</span><span class="p">::</span><span class="mi">2</span><span class="p">]]</span>

        <span class="n">offspring</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">empty</span><span class="p">((</span><span class="n">n_pairs</span> <span class="o">*</span> <span class="mi">2</span><span class="p">,</span> <span class="bp">self</span><span class="p">.</span><span class="n">num_genes</span><span class="p">),</span> <span class="n">dtype</span><span class="o">=</span><span class="n">population</span><span class="p">.</span><span class="n">dtype</span><span class="p">)</span>

        <span class="n">crossover_mask</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">rand</span><span class="p">(</span><span class="n">n_pairs</span><span class="p">)</span> <span class="o">&lt;=</span> <span class="bp">self</span><span class="p">.</span><span class="n">crossover_rate</span>

        <span class="n">crossover_points</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randint</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="bp">self</span><span class="p">.</span><span class="n">num_genes</span><span class="p">,</span> <span class="n">size</span><span class="o">=</span><span class="n">n_pairs</span><span class="p">)</span>

        <span class="n">gene_indices</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">arange</span><span class="p">(</span><span class="bp">self</span><span class="p">.</span><span class="n">num_genes</span><span class="p">)</span>

        <span class="n">masks</span> <span class="o">=</span> <span class="n">gene_indices</span><span class="p">[</span><span class="bp">None</span><span class="p">,</span> <span class="p">:]</span> <span class="o">&lt;</span> <span class="n">crossover_points</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">]</span>

        <span class="n">offspring</span><span class="p">[::</span><span class="mi">2</span><span class="p">]</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">where</span><span class="p">(</span><span class="n">masks</span><span class="p">,</span> <span class="n">parents1</span><span class="p">,</span> <span class="n">parents2</span><span class="p">)</span>
        <span class="n">offspring</span><span class="p">[</span><span class="mi">1</span><span class="p">::</span><span class="mi">2</span><span class="p">]</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">where</span><span class="p">(</span><span class="n">masks</span><span class="p">,</span> <span class="n">parents2</span><span class="p">,</span> <span class="n">parents1</span><span class="p">)</span>

        <span class="n">no_crossover_mask</span> <span class="o">=</span> <span class="o">~</span><span class="n">crossover_mask</span>
        <span class="n">offspring</span><span class="p">[::</span><span class="mi">2</span><span class="p">][</span><span class="n">no_crossover_mask</span><span class="p">]</span> <span class="o">=</span> <span class="n">parents1</span><span class="p">[</span><span class="n">no_crossover_mask</span><span class="p">]</span>
        <span class="n">offspring</span><span class="p">[</span><span class="mi">1</span><span class="p">::</span><span class="mi">2</span><span class="p">][</span><span class="n">no_crossover_mask</span><span class="p">]</span> <span class="o">=</span> <span class="n">parents2</span><span class="p">[</span><span class="n">no_crossover_mask</span><span class="p">]</span>

        <span class="k">return</span> <span class="n">offspring</span><span class="p">[:</span> <span class="bp">self</span><span class="p">.</span><span class="n">population_size</span><span class="p">]</span>
</code></pre></div></div>

<p>El operador de cruce original trabaja a nivel de un solo par de individuos. Para cada pareja de padres, primero decide si se aplica o no el cruce en función de una probabilidad. En caso afirmativo, selecciona un punto de cruce y construye dos descendientes concatenando segmentos de los cromosomas parentales. Este proceso es conceptualmente simple y fácil de entender, pero requiere un bucle externo que itere sobre todos los pares de la población, lo que introduce un coste significativo cuando el tamaño poblacional o el número de genes es elevado.</p>

<p>La operación propiamente vectorizada aquí es el cruce de genes de todos los pares a la vez, sin bucles explícitos en <em>Python</em>. La operación <code class="language-plaintext highlighter-rouge">np.where</code> aplica la selección elemento a elemento sobre toda la matriz en una sola llamada.</p>

<p>Finalmente, los pares que no debían cruzarse se gestionan sobrescribiendo los descendientes generados con copias directas de los padres originales. Esta etapa mantiene la semántica del operador de cruce clásico, pero sigue utilizando indexación booleana vectorizada. El resultado es un algoritmo que conserva exactamente el mismo comportamiento genético que la versión iterativa, pero con una implementación más adecuada para grandes poblaciones.</p>

<p>La función principal <code class="language-plaintext highlighter-rouge">optimize</code> se simplifica bastante. Quedaría así:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">optimize</span><span class="p">(</span><span class="bp">self</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">:</span>
        <span class="n">population</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">initialize_population</span><span class="p">()</span>
        <span class="n">scores</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">fitness_func</span><span class="p">(</span><span class="n">population</span><span class="p">)</span>

        <span class="n">idx</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">argsort</span><span class="p">(</span><span class="n">scores</span><span class="p">)[::</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
        <span class="n">population</span> <span class="o">=</span> <span class="n">population</span><span class="p">[</span><span class="n">idx</span><span class="p">]</span>
        <span class="n">scores</span> <span class="o">=</span> <span class="n">scores</span><span class="p">[</span><span class="n">idx</span><span class="p">]</span>

        <span class="n">prev_best</span> <span class="o">=</span> <span class="n">scores</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
        <span class="n">elite_size</span> <span class="o">=</span> <span class="nb">int</span><span class="p">(</span><span class="bp">self</span><span class="p">.</span><span class="n">elitism_rate</span> <span class="o">*</span> <span class="bp">self</span><span class="p">.</span><span class="n">population_size</span><span class="p">)</span>

        <span class="k">for</span> <span class="n">it</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="bp">self</span><span class="p">.</span><span class="n">max_iter</span><span class="p">):</span>
            <span class="k">if</span> <span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">scores</span><span class="p">)</span> <span class="o">==</span> <span class="mi">0</span> <span class="ow">or</span> <span class="n">np</span><span class="p">.</span><span class="n">count_nonzero</span><span class="p">(</span><span class="n">scores</span><span class="p">)</span> <span class="o">&lt;</span> <span class="mi">2</span><span class="p">:</span>
                <span class="n">parent_indices</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">choice</span><span class="p">(</span>
                    <span class="nb">len</span><span class="p">(</span><span class="n">scores</span><span class="p">),</span> <span class="bp">self</span><span class="p">.</span><span class="n">population_size</span><span class="p">,</span> <span class="n">replace</span><span class="o">=</span><span class="bp">True</span>
                <span class="p">)</span>
            <span class="k">else</span><span class="p">:</span>
                <span class="n">probs</span> <span class="o">=</span> <span class="n">scores</span> <span class="o">/</span> <span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">scores</span><span class="p">)</span>
                <span class="n">parent_indices</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">choice</span><span class="p">(</span>
                    <span class="nb">len</span><span class="p">(</span><span class="n">scores</span><span class="p">),</span> <span class="bp">self</span><span class="p">.</span><span class="n">population_size</span><span class="p">,</span> <span class="n">replace</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">p</span><span class="o">=</span><span class="n">probs</span>
                <span class="p">)</span>

            <span class="n">offspring</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">crossover_vectorized</span><span class="p">(</span><span class="n">population</span><span class="p">,</span> <span class="n">parent_indices</span><span class="p">)</span>
            <span class="n">offspring</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">mutate_vectorized</span><span class="p">(</span><span class="n">offspring</span><span class="p">)</span>

            <span class="n">elites</span> <span class="o">=</span> <span class="n">population</span><span class="p">[:</span><span class="n">elite_size</span><span class="p">]</span>
            <span class="n">offspring</span> <span class="o">=</span> <span class="n">offspring</span><span class="p">[:</span> <span class="bp">self</span><span class="p">.</span><span class="n">population_size</span> <span class="o">-</span> <span class="n">elite_size</span><span class="p">]</span>

            <span class="n">population</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">vstack</span><span class="p">([</span><span class="n">elites</span><span class="p">,</span> <span class="n">offspring</span><span class="p">])</span>
            <span class="n">scores</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">fitness_func</span><span class="p">(</span><span class="n">population</span><span class="p">)</span>

            <span class="n">idx</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">argsort</span><span class="p">(</span><span class="n">scores</span><span class="p">)[::</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
            <span class="n">population</span> <span class="o">=</span> <span class="n">population</span><span class="p">[</span><span class="n">idx</span><span class="p">]</span>
            <span class="n">scores</span> <span class="o">=</span> <span class="n">scores</span><span class="p">[</span><span class="n">idx</span><span class="p">]</span>

            <span class="n">best</span> <span class="o">=</span> <span class="n">scores</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
            <span class="bp">self</span><span class="p">.</span><span class="n">best_fitness_history</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">best</span><span class="p">)</span>

            <span class="n">improvement</span> <span class="o">=</span> <span class="n">best</span> <span class="o">-</span> <span class="n">prev_best</span>
            <span class="k">if</span> <span class="mi">0</span> <span class="o">&lt;</span> <span class="n">improvement</span> <span class="o">&lt;</span> <span class="bp">self</span><span class="p">.</span><span class="n">epsilon</span><span class="p">:</span>
                <span class="k">break</span>

            <span class="n">prev_best</span> <span class="o">=</span> <span class="n">best</span>

        <span class="k">return</span> <span class="n">population</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
</code></pre></div></div>

<h2 id="comprobación-de-la-mejora">Comprobación de la mejora</h2>

<p>Ahora, ya tendríamos un <em>GA</em> mucho más optimizado. Los operadores principales se han reescrito de forma que aprovechen las ventajas de la vectorización. Ahora son capaces de aplicar operaciones masivas sobre toda la población, en vez de utilizar bucles de <em>Python</em>, los cuales son extremadamente lentos.</p>

<p>Para probar la eficacia de la vectorización, he programado un ejemplo en el que se lanzarán $5$ experimentos. Cada experimento tiene un tamaño de problema mayor que el anterior, en este caso el problema de la mochila, el cual ya expliqué en el post sobre <a href="/2025/12/30/algoritmos-geneticos">genéticos</a>. En cada experimento se hacen $5$ <em>runs</em> para minimizar el efecto de la aleatoriedad.</p>

<p>Antes de todo, definamos el <em>speed-up</em>:</p>

\[speed\_up=\frac{T_{secuencial}}{T_{vectorizado}}\]

<p>Es decir, es una métrica que mide cuántas veces es una versión más rápida que la otra. Un <em>speed-up</em> de $\times 2$ significa que la versión vectorizada tarda la mitad de tiempo.</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/vectorizacion-en-python/ga_comparison.png" alt="GA vectorizado vs GA secuencial" width="1000" class="center" />
  <figcaption class="center">GA vectorizado vs GA secuencial</figcaption>
</figure>

<p>En el gráfico se muestra el tiempo de ejecución en términos absolutos, siendo el vectorizado mucho mejor. El valor del <em>fitness</em> de las mejores soluciones son prácticamente iguales. Irrelevante, pero quería mostrarlo, ya que debe quedar claro que la función y capacidad del <em>GA</em> queda inalterada. El <em>speed-up</em> crece según aumenta el tamaño del problema, es decir, es más eficiente que el secuencial según crece el problema, pero esto solo ocurre en el número limitado de ejecuciones que hemos hecho. Analicemos como escalan ambos algoritmos.</p>

<p>Ambas versiones muestran una tendencia de crecimiento similar en escala logarítmica, lo que indica que comparten el mismo orden de complejidad. Sin embargo, el algoritmo vectorizado presenta una constante multiplicativa mucho menor, lo que se traduce en una mejora sustancial del tiempo de ejecución para cualquier tamaño de problema.</p>

<p>¿El resumen de todo esto? El <em>speed-up</em> probablemente tope con un límite según crece el problema, pero aún así será unas $\approx\times 2$ veces mejor que el secuencial. Si aumentásemos el tamaño del problema más veces, veríamos como la tendencia alcista de la eficiencia se suaviza.</p>

<h2 id="el-cambio-de-mentalidad">El cambio de mentalidad</h2>
<p>La moraleja es sencilla: la vectorización es una herramienta sencilla de aplicar y muy beneficiosa.</p>

<p>Menos bucles en <em>Python</em>, más operaciones en bloque, y un <em>GA</em> que escala mucho mejor sin cambiar su comportamiento genético. La idea clave es cambiar el chip: dejar de pensar en individuos sueltos y empezar a pensar en poblaciones completas. Al menos en mi experiencia, una vez haces ese click mental, empiezas a ver oportunidades de vectorización por todas partes.</p>]]></content><author><name></name></author><category term="algoritmos genéticos" /><category term="optimización" /><category term="vectorización" /><category term="machine learning" /><category term="python" /><category term="numpy" /><category term="eficiencia" /><summary type="html"><![CDATA[Qué es la vectorización en Python. Uso de técnicas de vectorización con la librería NumPy para acelerar tu código. Guía clara con ejemplos basados en algoritmos genéticos.]]></summary></entry><entry><title type="html">Algoritmos genéticos: optimización, teoría y ejemplos en Python</title><link href="https://migue8gl.dev/2025/12/30/algoritmos-geneticos.html" rel="alternate" type="text/html" title="Algoritmos genéticos: optimización, teoría y ejemplos en Python" /><published>2025-12-30T00:00:00+00:00</published><updated>2025-12-30T00:00:00+00:00</updated><id>https://migue8gl.dev/2025/12/30/algoritmos-geneticos</id><content type="html" xml:base="https://migue8gl.dev/2025/12/30/algoritmos-geneticos.html"><![CDATA[<h2 id="introducción">Introducción</h2>

<p>La optimización es un campo de estudio amplio y muy interesante. Mis primeras interacciones con este campo empezaron jugueteando con regresiones lineales y usando el clásico descenso del gradiente, programado manualmente. No solo resulta satisfactorio desde el punto de vista teórico, sino que también es extremadamente útil en la práctica. Cuando hablamos de optimización, la idea principal que suele venirnos a la cabeza es la de realizar una tarea de la mejor manera posible, utilizando la menor cantidad de recursos.</p>

<p>En nuestro día a día, que suele ser bastante ajetreado, todos intentamos optimizar distintos procesos cotidianos: limpiar, cocinar, desplazarnos, estudiar o trabajar, entre otros. De forma consciente o no, tomamos decisiones orientadas a ahorrar tiempo, esfuerzo o dinero, lo que constituye un ejemplo claro de optimización aplicada a la vida diaria.</p>

<p>En el ámbito del comercio, la optimización es un elemento casi inherente al propio sistema capitalista (al menos en su formulación teórica más ideal). Las empresas compiten entre sí tratando de ofrecer mejores bienes y servicios, y esta competencia actúa como motor para la mejora continua de los procesos. Por ejemplo, si una empresa de reparto de paquetes consigue realizar sus envíos de forma más rápida y utilizando menos combustible que otra, podrá ofrecer precios más competitivos. Al reducir el consumo de recursos, esta empresa más eficiente puede mantener (o incluso aumentar) su margen de beneficio frente a otra cuyo proceso logístico sea menos eficiente.</p>

<p>Este tipo de situaciones ilustran claramente problemas de optimización. En el caso del transporte, existen múltiples rutas posibles entre distintos destinos, pero no todas son igualmente buenas. El objetivo es encontrar el recorrido óptimo en función de ciertas variables, como el tráfico en un momento determinado, la existencia de obras, la distancia entre puntos de entrega o el consumo de combustible. La optimización permite modelar este problema y determinar, entre todas las alternativas posibles, aquella que minimiza el coste total o maximiza la eficiencia del proceso.</p>

<p>Dentro de este campo de estudio, existen multitud de herramientas matemáticas y de métodos para optimizar un problema. Como breve resumen, enumeraré algunos de los enfoques más usados:</p>

<ul>
  <li><strong>Algoritmos basados en gradiente</strong>: utilizan información de derivadas de la función objetivo para guiar la búsqueda hacia óptimos locales o globales. Son muy eficientes cuando la función es continua y diferenciable (por ejemplo, descenso por gradiente o métodos de <em>Newton</em>).</li>
  <li><strong>Metaheurísticas</strong>: métodos de búsqueda aproximada inspirados en procesos naturales o estrategias probabilísticas. No garantizan el óptimo global, pero son muy útiles en problemas complejos, no lineales o discontinuos. En este blog hablaré sobre los <a href="https://en.wikipedia.org/wiki/Genetic_algorithm">algoritmos genéticos</a>, el ejemplo más básico de metaheurística.</li>
  <li><strong>Métodos exactos</strong>: técnicas matemáticas que garantizan encontrar la solución óptima, como la programación lineal, entera o convexa. Suelen ser computacionalmente costosos y aplicables solo a problemas con una estructura bien definida.</li>
  <li><strong>Métodos heurísticos</strong>: estrategias diseñadas específicamente para un tipo de problema concreto, que priorizan la rapidez frente a la optimalidad. Son comunes en problemas de gran escala o en tiempo real.</li>
</ul>

<p>Para poder definir un problema general como un problema de optimización, es necesario establecer ciertos elementos fundamentales que lo definan de manera clara y precisa. Matemáticamente, y de forma simplificada, un problema de optimización tiene esta forma:</p>

\[\begin{aligned}
\text{Función objetivo a minimizar} \quad &amp; f(x) \\
\text{sujeto a} \quad 
&amp; g_j(x) \le 0, \quad j = 1,2,\ldots,s, \\
&amp; h_j(x) = 0, \quad j = 1,2,\ldots,w, \\
&amp; x_i, \quad i = 1,2,\ldots,n.
\end{aligned}\]

<p>De forma resumida, tenemos una función que queremos minimizar o maximizar, junto con una serie de restricciones que hay que cumplir. En el ejemplo del transportista, lo que queremos es gastar el menor combustible posible, pero con la condición de que no podemos pasar por las calles $x$ e $y$ debido a las obras, y de que hay que visitar todas las casas del recorrido.</p>

<p>A continuación explicaré brevemente algunos conceptos que son indispensables para entender el diseño de los métodos de optimización.</p>

<h2 id="conceptos-clave">Conceptos clave</h2>

<h3 id="función-fitness">Función <strong>fitness</strong></h3>

<p>Esta función establece una forma de evaluar soluciones para nuestro problema. Es una forma de cuantificar el rendimiento. También puede ser vista como una forma de cuantificar un error. En ese caso, deberíamos minimizarla.</p>

<h3 id="óptimos-globales-y-locales">Óptimos globales y locales</h3>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/algoritmos-geneticos/min-max-points.png" alt="Esta imagen, sacada del libro Introduction to Optimization, muestra como en una función pueden existir distintos picos con valores máximos o mínimos locales. El objetivo es encontrar los valores globales, pero algunos métodos se contentan con un buen óptimo local" width="500" class="center" />
  <figcaption class="center">Esta imagen, sacada del libro Introduction to Optimization, muestra como en una función pueden existir distintos picos con valores máximos o mínimos locales. El objetivo es encontrar los valores globales, pero algunos métodos se contentan con un buen óptimo local</figcaption>
</figure>

<p>Imaginemos una función como una superficie en $3D$, quizá semejante a una cadena montañosa, con picos y llena de valles y depresiones. Así es más sencillo entender estos conceptos. Encontrar el óptimo global correspondería a encontrar el punto más bajo de toda la superficie, el valle más profundo de la región. En la búsqueda por descender lo máximo posible, es posible quedarse atrapado en depresiones menos profundas que, en relación con su entorno inmediato, son las más bajas. Estos son los óptimos locales.</p>

<p>Un senderista que se mueve por este terreno no tiene una visión completa del paisaje. Solo percibe la pendiente inmediata que le rodea. Su estrategia es simple: avanzar siempre cuesta abajo.</p>

<p>Siguiendo esta regla, el senderista acabará llegando a un punto donde todas las direcciones cercanas ascienden. Desde su punto de vista, ha alcanzado el fondo del valle: cualquier paso que dé lo hará subir. Sin embargo, ese punto puede no ser el lugar más bajo de toda la región, sino solo el más bajo en su entorno inmediato. Ese punto corresponde a un óptimo local.</p>

<p>Algunos métodos topan con la misma problemática del senderista. Se quedan atascados en valores subóptimos.</p>

<p>Dentro de todos los métodos de optimización existentes, hay unos que son bastante divertidos e interesantes. Son fáciles de programar, intuitivos y generalmente funcionan muy bien. Estas son las llamadas <strong>metaheurísticas</strong>, métodos cuya principal característica es la aleatoriedad como motor principal de exploración. Y concretamente dentro de estos algoritmos, voy a hablar de los algoritmos genéticos.</p>

<h2 id="algoritmos-genéticos">Algoritmos genéticos</h2>

<p>La premisa es básica. Esta familia de algoritmos se inspira en las ideas de <em>Darwin</em> sobre la evolución, más concretamente, en los mecanismos de selección natural y supervivencia del más apto, donde los individuos mejor adaptados al entorno tienen mayor probabilidad de reproducirse y transmitir sus características a la siguiente generación.</p>

<p>Estos sistemas (y todas las metaheurísticas) tienen dos fases generales de vital importancia y muy sensibles. La exploración y la explotación.</p>

<h3 id="exploración-y-explotación">Exploración y explotación</h3>

<p>Como he mencionado antes, la aleatoriedad es una parte clave de estas técnicas. Esta característica permite explorar zonas del espacio que quizá no habrían sido visitadas en primera instancia por parecer menos prometedoras. Gracias a ello, se permite una exploración más amplia y se facilita escapar de óptimos locales. Esta primera fase de búsqueda es la conocida como <strong>exploración</strong>.</p>

<p>La <strong>explotación</strong> viene justo después. Esta es la habilidad de refinar y ajustar lo máximo posible una zona de soluciones, encontrando la mejor solución posible dentro de esta.</p>

<p>El balance entre ambas fases es muy sensible y es necesario ajustarlo con finura. Si la exploración dominase, el algoritmo tardaría mucho tiempo en conseguir una solución, o incluso no convergería a ninguna. En cambio, si la explotación fuese más fuerte que la exploración, la convergencia sería muy prematura y posiblemente se encontraría una solución subóptima, cuando podría haber muchas mejores opciones sin descubrir.</p>

<p>Los algoritmos genéticos son capaces de explorar y explotar gracias a su variada selección de operadores. Aunque, antes de profundizar en detalles sobre estos, hay que entender el algoritmo de forma general.</p>

<p>Las <strong>GAs</strong> trabajan con una población de soluciones codificadas normalmente en forma binaria. Cada solución, llamada cromosoma, está compuesta por genes (<em>bits</em>), y el conjunto de cromosomas constituye la población. Esta población se inicializa de manera aleatoria para favorecer la exploración del espacio de soluciones y, posteriormente, cada cromosoma es evaluado según su calidad, lo que hace posible ordenar las soluciones de mejor a peor. A partir de esta evaluación comienza el proceso evolutivo, que se desarrolla en generaciones. En cada generación se seleccionan los cromosomas más aptos para reproducirse, sin eliminar completamente la diversidad.</p>

<p>Los operadores genéticos principales son el cruce, que combina información de dos progenitores para generar nuevas soluciones, y la mutación, que introduce cambios aleatorios para evitar la convergencia prematura. El operador de selección es también importante, pues es el encargado de indicar qué cromosomas deben cruzarse entre sí. También es posible añadir una mecánica de elitismo, para mejorar la convergencia. Con apoyo del elitismo, que preserva las mejores soluciones, este ciclo se repite hasta cumplir un criterio de parada, tomando finalmente el mejor cromosoma como solución aproximada al problema. A continuación proporciono un diagrama general del ciclo evolutivo:</p>

<pre><code class="language-mermaid">graph TD
    A[Inicio] --&gt; B[Inicializar población aleatoria]
    B --&gt; C[Evaluar fitness de toda la población]
    C --&gt; D[Ordenar por fitness]
    D --&gt; E{¿Iteración &lt; max_iter?}
    E --&gt;|No| P[Retornar mejor solución]
    E --&gt;|Sí| F[Seleccionar élites]
    F --&gt; G{¿Población completa?}
    G --&gt;|No| H[Selección por ruleta]
    H --&gt; I[Crossover de padres]
    I --&gt; J[Mutación de hijos]
    J --&gt; K[Agregar hijos a nueva población]
    K --&gt; G
    G --&gt;|Sí| L[Evaluar fitness de nueva población]
    L --&gt; M[Ordenar por fitness]
    M --&gt; N[Guardar mejor fitness en historial]
    N --&gt; O{¿Mejora &lt; epsilon?}
    O --&gt;|Sí| P
    O --&gt;|No| E
    P --&gt; Q[Fin]
</code></pre>
<h3 id="de-la-teoría-a-la-práctica">De la teoría a la práctica</h3>

<p>Dentro del diseño principal de los genéticos, hay una variedad muy grande de operadores. A lo largo de los años han ido surgiendo distintos diseños y evoluciones de los operadores básicos. Aquí implementaré los más sencillos.</p>

<p>La siguiente clase contiene los parámetros de inicialización del algoritmo. El parámetro <code class="language-plaintext highlighter-rouge">fitness_func</code> hace referencia a la función <em>fitness</em>. Esta es la función objetivo que vamos a maximizar. Veremos que de esta también depende la calidad de nuestra solución, pues hay múltiples formas de abordar la evaluación de un cromosoma. El resto de parámetros son evidentes: el tamaño de la población, número de genes de cada solución, probabilidad de mutación por gen, iteraciones máximas, mejora mínima por generación (cuando deja de mejorar un mínimo el algoritmo para), probabilidad de cruce, porcentaje de elitismo en función del tamaño de la población y una semilla (por reproducibilidad en experimentación).</p>

<p>La población se genera siguiendo una distribución discreta uniforme, pero esto es cuestión de diseño, podría utilizarse otra distribución.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">GA</span><span class="p">:</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span>
        <span class="bp">self</span><span class="p">,</span>
        <span class="n">fitness_func</span><span class="p">:</span> <span class="n">Callable</span><span class="p">,</span>
        <span class="n">population_size</span><span class="p">:</span> <span class="nb">int</span><span class="p">,</span>
        <span class="n">num_genes</span><span class="p">:</span> <span class="nb">int</span><span class="p">,</span>
        <span class="n">mutation_rate</span><span class="p">:</span> <span class="nb">float</span><span class="p">,</span>
        <span class="n">max_iter</span><span class="p">:</span> <span class="nb">int</span><span class="p">,</span>
        <span class="n">epsilon</span><span class="p">:</span> <span class="nb">float</span><span class="p">,</span>
        <span class="n">crossover_rate</span><span class="p">:</span> <span class="nb">float</span> <span class="o">=</span> <span class="mf">0.8</span><span class="p">,</span>
        <span class="n">elitism_rate</span><span class="p">:</span> <span class="nb">float</span> <span class="o">=</span> <span class="mf">0.1</span><span class="p">,</span>
        <span class="n">seed</span><span class="p">:</span> <span class="n">Optional</span><span class="p">[</span><span class="nb">int</span><span class="p">]</span> <span class="o">=</span> <span class="bp">None</span><span class="p">,</span>
    <span class="p">):</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">fitness_func</span> <span class="o">=</span> <span class="n">fitness_func</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">population_size</span> <span class="o">=</span> <span class="n">population_size</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">num_genes</span> <span class="o">=</span> <span class="n">num_genes</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">mutation_rate</span> <span class="o">=</span> <span class="n">mutation_rate</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">max_iter</span> <span class="o">=</span> <span class="n">max_iter</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">epsilon</span> <span class="o">=</span> <span class="n">epsilon</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">crossover_rate</span> <span class="o">=</span> <span class="n">crossover_rate</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">elitism_rate</span> <span class="o">=</span> <span class="n">elitism_rate</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">best_fitness_history</span> <span class="o">=</span> <span class="p">[]</span>
        <span class="k">if</span> <span class="n">seed</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
            <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">seed</span><span class="p">(</span><span class="n">seed</span><span class="p">)</span>
            <span class="n">random</span><span class="p">.</span><span class="n">seed</span><span class="p">(</span><span class="n">seed</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">initialize_population</span><span class="p">(</span><span class="bp">self</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">:</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">population</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randint</span><span class="p">(</span>
            <span class="n">low</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span> <span class="n">high</span><span class="o">=</span><span class="mi">2</span><span class="p">,</span> <span class="n">size</span><span class="o">=</span><span class="p">(</span><span class="bp">self</span><span class="p">.</span><span class="n">population_size</span><span class="p">,</span> <span class="bp">self</span><span class="p">.</span><span class="n">num_genes</span><span class="p">)</span>
        <span class="p">)</span>
        <span class="k">return</span> <span class="bp">self</span><span class="p">.</span><span class="n">population</span>
</code></pre></div></div>

<p>El operador de cruce es sencillo. Este concretamente recibe el nombre de <em>one-point crossover</em> ya que se selecciona un punto al azar entre las dos soluciones padre.</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/algoritmos-geneticos/one-point-crossover.png" alt="One-point-crossover" width="500" class="center" />
  <figcaption class="center">One-point-crossover</figcaption>
</figure>

<p>Dado ese punto de corte, se mezcla la parte izquierda de un padre con la parte derecha de otro y viceversa, generando en el proceso dos soluciones hijo.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">crossover</span><span class="p">(</span>
        <span class="bp">self</span><span class="p">,</span> <span class="n">x1</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">,</span> <span class="n">x2</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span>
    <span class="p">)</span> <span class="o">-&gt;</span> <span class="n">Tuple</span><span class="p">[</span><span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">,</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">]:</span>
        <span class="k">if</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">rand</span><span class="p">()</span> <span class="o">&gt;</span> <span class="bp">self</span><span class="p">.</span><span class="n">crossover_rate</span><span class="p">:</span>
            <span class="k">return</span> <span class="n">x1</span><span class="p">.</span><span class="n">copy</span><span class="p">(),</span> <span class="n">x2</span><span class="p">.</span><span class="n">copy</span><span class="p">()</span>
        <span class="n">point</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">randint</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">x1</span><span class="p">.</span><span class="n">size</span><span class="p">)</span>
        <span class="n">c1</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">concatenate</span><span class="p">([</span><span class="n">x1</span><span class="p">[:</span><span class="n">point</span><span class="p">],</span> <span class="n">x2</span><span class="p">[</span><span class="n">point</span><span class="p">:]])</span>
        <span class="n">c2</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">concatenate</span><span class="p">([</span><span class="n">x2</span><span class="p">[:</span><span class="n">point</span><span class="p">],</span> <span class="n">x1</span><span class="p">[</span><span class="n">point</span><span class="p">:]])</span>
        <span class="k">return</span> <span class="n">c1</span><span class="p">,</span> <span class="n">c2</span>
</code></pre></div></div>

<p>El operador de mutación, en el caso de la mutación binaria, no tiene mucho misterio. Se recorre cada gen de un cromosoma, generando un número aleatorio por cada iteración. Con una probabilidad baja se realizará esa mutación, que consiste en un cambio del <em>bit</em>. Si era $0$ cambia a $1$ y viceversa. Esta probabilidad suele ser baja para evitar que el proceso se vuelva excesivamente aleatorio y se pierda la información genética acumulada por selección y cruce.</p>

<p>Este operador introduce aleatoriedad en el algoritmo, de forma que se favorece a la exploración del espacio de soluciones.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">mutate</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">x</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">:</span>
        <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="n">size</span><span class="p">):</span>
            <span class="k">if</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">rand</span><span class="p">()</span> <span class="o">&lt;</span> <span class="bp">self</span><span class="p">.</span><span class="n">mutation_rate</span><span class="p">:</span>
                <span class="n">x</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="o">=</span> <span class="mi">1</span> <span class="o">-</span> <span class="n">x</span><span class="p">[</span><span class="n">i</span><span class="p">]</span>
        <span class="k">return</span> <span class="n">x</span>
</code></pre></div></div>

<p>El operador de selección es uno de los componentes fundamentales de los algoritmos genéticos y se encarga de decidir qué individuos de la población pasan a reproducirse y, por tanto, a transmitir su información genética a la siguiente generación. Su funcionamiento se basa en el principio de la supervivencia del más apto, es decir, los que mejor evaluación tienen dada la función <em>fitness</em>. En este caso he implementado una ruleta, que es sencilla de programar y de entender. La probabilidad de selección de cada individuo es proporcional a su aptitud.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">roulette_wheel</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">scores</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">:</span>
        <span class="k">if</span> <span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">scores</span><span class="p">)</span> <span class="o">==</span> <span class="mi">0</span> <span class="ow">or</span> <span class="n">np</span><span class="p">.</span><span class="n">count_nonzero</span><span class="p">(</span><span class="n">scores</span><span class="p">)</span> <span class="o">&lt;</span> <span class="mi">2</span><span class="p">:</span>
            <span class="k">return</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">choice</span><span class="p">(</span><span class="nb">len</span><span class="p">(</span><span class="n">scores</span><span class="p">),</span> <span class="mi">2</span><span class="p">,</span> <span class="n">replace</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">probs</span> <span class="o">=</span> <span class="n">scores</span> <span class="o">/</span> <span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">scores</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">np</span><span class="p">.</span><span class="n">random</span><span class="p">.</span><span class="n">choice</span><span class="p">(</span><span class="nb">len</span><span class="p">(</span><span class="n">scores</span><span class="p">),</span> <span class="mi">2</span><span class="p">,</span> <span class="n">replace</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">p</span><span class="o">=</span><span class="n">probs</span><span class="p">)</span>
</code></pre></div></div>

<p>Finalmente, una vez se han explicado los operadores, queda la evolución generacional. Como he mencionado, se modifica la población completa generación tras generación siguiendo el siguiente bucle: Selección de padres, cruce de padres, mutación y reemplazo de la población. El elitismo es opcional, pero he optado por añadirlo ya que en mi experiencia no promueve una convergencia muy temprana si el número es bajo y mejora mucho la calidad de las soluciones.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">optimize</span><span class="p">(</span><span class="bp">self</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">:</span>
        <span class="n">population</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">initialize_population</span><span class="p">()</span>
        <span class="n">scores</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">fitness_func</span><span class="p">(</span><span class="n">population</span><span class="p">)</span>

        <span class="n">idx</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">argsort</span><span class="p">(</span><span class="n">scores</span><span class="p">)[::</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
        <span class="n">population</span> <span class="o">=</span> <span class="n">population</span><span class="p">[</span><span class="n">idx</span><span class="p">]</span>
        <span class="n">scores</span> <span class="o">=</span> <span class="n">scores</span><span class="p">[</span><span class="n">idx</span><span class="p">]</span>

        <span class="n">prev_best</span> <span class="o">=</span> <span class="n">scores</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
        <span class="n">elite_size</span> <span class="o">=</span> <span class="nb">int</span><span class="p">(</span><span class="bp">self</span><span class="p">.</span><span class="n">elitism_rate</span> <span class="o">*</span> <span class="bp">self</span><span class="p">.</span><span class="n">population_size</span><span class="p">)</span>

        <span class="k">for</span> <span class="n">it</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="bp">self</span><span class="p">.</span><span class="n">max_iter</span><span class="p">):</span>
            <span class="n">new_population</span> <span class="o">=</span> <span class="p">[]</span>

            <span class="n">elites</span> <span class="o">=</span> <span class="n">population</span><span class="p">[:</span><span class="n">elite_size</span><span class="p">]</span>
            <span class="n">new_population</span><span class="p">.</span><span class="n">extend</span><span class="p">(</span><span class="n">elites</span><span class="p">)</span>

            <span class="k">while</span> <span class="nb">len</span><span class="p">(</span><span class="n">new_population</span><span class="p">)</span> <span class="o">&lt;</span> <span class="bp">self</span><span class="p">.</span><span class="n">population_size</span><span class="p">:</span>
                <span class="n">i1</span><span class="p">,</span> <span class="n">i2</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">roulette_wheel</span><span class="p">(</span><span class="n">scores</span><span class="p">)</span>
                <span class="n">p1</span><span class="p">,</span> <span class="n">p2</span> <span class="o">=</span> <span class="n">population</span><span class="p">[</span><span class="n">i1</span><span class="p">],</span> <span class="n">population</span><span class="p">[</span><span class="n">i2</span><span class="p">]</span>
                <span class="n">c1</span><span class="p">,</span> <span class="n">c2</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">crossover</span><span class="p">(</span><span class="n">p1</span><span class="p">,</span> <span class="n">p2</span><span class="p">)</span>
                <span class="n">c1</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">mutate</span><span class="p">(</span><span class="n">c1</span><span class="p">)</span>
                <span class="n">c2</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">mutate</span><span class="p">(</span><span class="n">c2</span><span class="p">)</span>
                <span class="n">new_population</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">c1</span><span class="p">)</span>
                <span class="k">if</span> <span class="nb">len</span><span class="p">(</span><span class="n">new_population</span><span class="p">)</span> <span class="o">&lt;</span> <span class="bp">self</span><span class="p">.</span><span class="n">population_size</span><span class="p">:</span>
                    <span class="n">new_population</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">c2</span><span class="p">)</span>

            <span class="n">population</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">(</span><span class="n">new_population</span><span class="p">)</span>
            <span class="n">scores</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">fitness_func</span><span class="p">(</span><span class="n">population</span><span class="p">)</span>

            <span class="n">idx</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">argsort</span><span class="p">(</span><span class="n">scores</span><span class="p">)[::</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
            <span class="n">population</span> <span class="o">=</span> <span class="n">population</span><span class="p">[</span><span class="n">idx</span><span class="p">]</span>
            <span class="n">scores</span> <span class="o">=</span> <span class="n">scores</span><span class="p">[</span><span class="n">idx</span><span class="p">]</span>

            <span class="n">best</span> <span class="o">=</span> <span class="n">scores</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
            <span class="bp">self</span><span class="p">.</span><span class="n">best_fitness_history</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">best</span><span class="p">)</span>

            <span class="n">improvement</span> <span class="o">=</span> <span class="n">best</span> <span class="o">-</span> <span class="n">prev_best</span>
            <span class="k">if</span> <span class="mi">0</span> <span class="o">&lt;</span> <span class="n">improvement</span> <span class="o">&lt;</span> <span class="bp">self</span><span class="p">.</span><span class="n">epsilon</span><span class="p">:</span>
                <span class="k">print</span><span class="p">(</span>
                    <span class="sa">f</span><span class="s">"Early stopping at iteration </span><span class="si">{</span><span class="n">it</span> <span class="o">+</span> <span class="mi">1</span><span class="si">}</span><span class="s">: improvement (</span><span class="si">{</span><span class="n">improvement</span><span class="si">:</span><span class="p">.</span><span class="mi">6</span><span class="n">f</span><span class="si">}</span><span class="s">) &lt; epsilon (</span><span class="si">{</span><span class="bp">self</span><span class="p">.</span><span class="n">epsilon</span><span class="si">}</span><span class="s">)"</span>
                <span class="p">)</span>
                <span class="k">break</span>

            <span class="n">prev_best</span> <span class="o">=</span> <span class="n">best</span>

        <span class="k">return</span> <span class="n">population</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
</code></pre></div></div>

<h2 id="el-problema-de-la-mochila">El problema de la mochila</h2>

<p>Como problema de ejemplo para optimizar y visualizar el comportamiento de este algoritmo he escogido el <em>problema de la mochila</em> o <a href="https://en.wikipedia.org/wiki/Knapsack_problem">Knapsack Problem</a>, un clásico.</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/algoritmos-geneticos/knapsack-problem1.jpg" alt="Ejemplo del problema de la mochila" width="500" class="center" />
  <figcaption class="center">Ejemplo del problema de la mochila</figcaption>
</figure>

<p>Este consiste en seleccionar, de entre un conjunto de objetos con un peso y un valor asociados, aquellos que deben introducirse en una mochila con capacidad limitada para maximizar el valor total sin exceder dicha capacidad.</p>

<p>Para poder trabajar en este problema con algoritmos genéticos, la codificación de las soluciones deberá tomar la forma de un vector binario, donde cada gen representa un objeto candidato a ser introducido en la mochila: el valor $1$ indica que el objeto es seleccionado y el valor $0$ que no lo es.</p>

\[\mathbf{x} = (x_1, x_2, \dots, x_n), \quad x_i \in \{0,1\}, \quad
x_i =
\begin{cases}
1 &amp; \text{si el objeto } i \text{ es seleccionado} \\
0 &amp; \text{en caso contrario}
\end{cases}\]

\[W(\mathbf{x}) = \sum_{i=1}^{n} w_i x_i \leq W_{\max}\]

\[V(\mathbf{x}) = \sum_{i=1}^{n} v_i x_i\]

<p>En esta formulación, $\mathbf{x}$ es una solución candidata formada por $n$ objetos, $x_i$ indica la selección del objeto $i$, $w_i$ y $v_i$ representan respectivamente el peso y el valor del objeto $i$, $W(\mathbf{x})$ es el peso total de la solución, $W_{\max}$ la capacidad máxima de la mochila, y $V(\mathbf{x})$ el valor total de la solución, que se utiliza como función <em>fitness</em>.</p>

<h3 id="funciones-de-evaluación-fitness">Funciones de evaluación (<em>fitness</em>)</h3>

<p>Vamos a probar a solucionar este problema con el algoritmo genético básico que he presentado previamente. Para ello, antes de todo, debemos escoger una función <em>fitness</em>. Aquí entran dos tipos de evaluaciones que podemos hacer sobre una solución. Si la solución se excede en carga, podemos penalizarla de forma drástica, añadiendo un <em>score</em> de $0$, por ejemplo, y dejando el valor total como <em>score</em> para aquellos cromosomas que no violen la restricción. Esto funciona, pero tiene problemas. Imaginemos que tenemos dos soluciones de igual valor. Una se excede por $4kg$ y otra se excede por $0.3kg$. La función de evaluación daría la misma puntuación a ambas soluciones, cuando claramente hay una peor que otra.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">fitness_knapsack_hard</span><span class="p">(</span>
    <span class="n">population</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">,</span>
    <span class="n">weights</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">,</span>
    <span class="n">values</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">,</span>
    <span class="n">max_capacity</span><span class="p">:</span> <span class="nb">int</span><span class="p">,</span>
<span class="p">)</span> <span class="o">-&gt;</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">:</span>
    <span class="n">total_weights</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">population</span> <span class="o">*</span> <span class="n">weights</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">total_values</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">population</span> <span class="o">*</span> <span class="n">values</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">total_values</span><span class="p">[</span><span class="n">total_weights</span> <span class="o">&gt;</span> <span class="n">max_capacity</span><span class="p">]</span> <span class="o">=</span> <span class="mf">0.0</span>

    <span class="k">return</span> <span class="n">total_values</span>
</code></pre></div></div>

<p>Esto lo que le está diciendo al algoritmo es que debe darle la misma importancia a una que a otra. Podríamos estar sesgando la capacidad de exploración entre las ramificaciones de posibles soluciones hijas generadas a partir de la solución menos mala. También podría ocurrir que el algoritmo contenga una población de malas soluciones a las cuales no podría seguir evolucionando para intentar mejorar. Es una visión pesimista. La penalización binaria elimina la información sobre cómo de lejos está una solución de ser factible, reduciendo la capacidad del algoritmo para realizar mejoras graduales.</p>

<p>Una opción alternativa sería penalizar suavemente, teniendo en cuenta la magnitud de la violación. La función <code class="language-plaintext highlighter-rouge">fitness_knapsack_soft</code> evalúa cada individuo en base a su valor total. Si esa solución se excede en peso total del máximo permitido, se introduce una penalización gradual que crece de manera exponencial. El factor $\alpha$ controla si se aplica más o menos penalización.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">fitness_knapsack_soft</span><span class="p">(</span>
    <span class="n">population</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">,</span>
    <span class="n">weights</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">,</span>
    <span class="n">values</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">,</span>
    <span class="n">max_capacity</span><span class="p">:</span> <span class="nb">float</span><span class="p">,</span>
    <span class="n">alpha</span><span class="p">:</span> <span class="nb">float</span> <span class="o">=</span> <span class="mf">0.2</span><span class="p">,</span>
<span class="p">)</span> <span class="o">-&gt;</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">:</span>
    <span class="n">total_weights</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">population</span> <span class="o">*</span> <span class="n">weights</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
    <span class="n">total_values</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nb">sum</span><span class="p">(</span><span class="n">population</span> <span class="o">*</span> <span class="n">values</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>

    <span class="n">excess</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">maximum</span><span class="p">(</span><span class="mf">0.0</span><span class="p">,</span> <span class="n">total_weights</span> <span class="o">-</span> <span class="n">max_capacity</span><span class="p">)</span>
    <span class="n">penalty</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">exp</span><span class="p">(</span><span class="o">-</span><span class="n">alpha</span> <span class="o">*</span> <span class="n">excess</span><span class="p">)</span>

    <span class="k">return</span> <span class="n">total_values</span> <span class="o">*</span> <span class="n">penalty</span>
</code></pre></div></div>

<h3 id="resolución">Resolución</h3>

<p>Vamos a comparar el <strong>GA</strong> con varios tamaños de problema y distintas restricciones con la función de evaluación suave y la dura. Además vamos a compararlo con un algoritmo <em>Greedy</em> para analizar las diferencias en calidad de solución, tiempo de cómputo y cumplimiento de restricciones. El algoritmo <em>Greedy</em> es muy simple. Utiliza una heurística básica de ordenación y va escogiendo el mejor camino posible en cada paso hasta completar la solución final. Es muy rápido y, dependiendo de la heurística elegida, muy competente.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">Greedy</span><span class="p">:</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span>
        <span class="bp">self</span><span class="p">,</span>
        <span class="n">weights</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">,</span>
        <span class="n">values</span><span class="p">:</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">,</span>
        <span class="n">max_capacity</span><span class="p">:</span> <span class="nb">float</span><span class="p">,</span>
        <span class="n">heuristic</span><span class="p">:</span> <span class="nb">str</span><span class="p">,</span>
        <span class="n">fitness_func</span><span class="p">:</span> <span class="n">Callable</span><span class="p">,</span>
    <span class="p">):</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">weights</span> <span class="o">=</span> <span class="n">weights</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">values</span> <span class="o">=</span> <span class="n">values</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">max_capacity</span> <span class="o">=</span> <span class="n">max_capacity</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">fitness_func</span> <span class="o">=</span> <span class="n">fitness_func</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">heuristic</span> <span class="o">=</span> <span class="n">heuristic</span>
        <span class="bp">self</span><span class="p">.</span><span class="n">best_fitness_history</span> <span class="o">=</span> <span class="p">[]</span>

    <span class="k">def</span> <span class="nf">optimize</span><span class="p">(</span><span class="bp">self</span><span class="p">)</span> <span class="o">-&gt;</span> <span class="n">np</span><span class="p">.</span><span class="n">ndarray</span><span class="p">:</span>
        <span class="n">n</span> <span class="o">=</span> <span class="nb">len</span><span class="p">(</span><span class="bp">self</span><span class="p">.</span><span class="n">weights</span><span class="p">)</span>
        <span class="n">solution</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">zeros</span><span class="p">(</span><span class="n">n</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="nb">int</span><span class="p">)</span>

        <span class="k">if</span> <span class="bp">self</span><span class="p">.</span><span class="n">heuristic</span> <span class="o">==</span> <span class="s">"h1"</span><span class="p">:</span>
            <span class="n">ratios</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">values</span>  
            <span class="n">order</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">argsort</span><span class="p">(</span><span class="o">-</span><span class="n">ratios</span><span class="p">)</span>
        <span class="k">elif</span> <span class="bp">self</span><span class="p">.</span><span class="n">heuristic</span> <span class="o">==</span> <span class="s">"h2"</span><span class="p">:</span>
            <span class="n">ratios</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">weights</span>  
            <span class="n">order</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">argsort</span><span class="p">(</span><span class="n">ratios</span><span class="p">)</span>  
        <span class="k">else</span><span class="p">:</span>
            <span class="n">ratios</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">values</span> <span class="o">/</span> <span class="bp">self</span><span class="p">.</span><span class="n">weights</span> 
            <span class="n">order</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">argsort</span><span class="p">(</span><span class="o">-</span><span class="n">ratios</span><span class="p">)</span>

        <span class="n">remaining_capacity</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">max_capacity</span>
        <span class="n">best_fitness</span> <span class="o">=</span> <span class="nb">float</span><span class="p">(</span><span class="s">"-inf"</span><span class="p">)</span>

        <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="n">order</span><span class="p">:</span>
            <span class="k">if</span> <span class="bp">self</span><span class="p">.</span><span class="n">weights</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="o">&lt;=</span> <span class="n">remaining_capacity</span><span class="p">:</span>
                <span class="n">solution</span><span class="p">[</span><span class="n">i</span><span class="p">]</span> <span class="o">=</span> <span class="mi">1</span>
                <span class="n">remaining_capacity</span> <span class="o">-=</span> <span class="bp">self</span><span class="p">.</span><span class="n">weights</span><span class="p">[</span><span class="n">i</span><span class="p">]</span>

                <span class="n">current_fitness</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">fitness_func</span><span class="p">(</span><span class="n">solution</span><span class="p">.</span><span class="n">reshape</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">))[</span><span class="mi">0</span><span class="p">]</span>
                <span class="k">if</span> <span class="n">current_fitness</span> <span class="o">&gt;</span> <span class="n">best_fitness</span><span class="p">:</span>
                    <span class="n">best_fitness</span> <span class="o">=</span> <span class="n">current_fitness</span>
                    <span class="bp">self</span><span class="p">.</span><span class="n">best_fitness_history</span><span class="p">.</span><span class="n">append</span><span class="p">(</span><span class="n">best_fitness</span><span class="p">)</span>

        <span class="k">if</span> <span class="ow">not</span> <span class="bp">self</span><span class="p">.</span><span class="n">best_fitness_history</span><span class="p">:</span>
            <span class="bp">self</span><span class="p">.</span><span class="n">best_fitness_history</span><span class="p">.</span><span class="n">append</span><span class="p">(</span>
                <span class="bp">self</span><span class="p">.</span><span class="n">fitness_func</span><span class="p">(</span><span class="n">solution</span><span class="p">.</span><span class="n">reshape</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">))[</span><span class="mi">0</span><span class="p">]</span>
            <span class="p">)</span>

        <span class="k">return</span> <span class="n">solution</span>
</code></pre></div></div>

<p>Para <em>Greedy</em> he definido tres heurísticas básicas. Ordenación de mejores objetos en función del valor, del peso y del valor relativo al peso.</p>

<table border="1" cellspacing="0" cellpadding="6">
  <thead>
    <tr>
      <th>Heurística</th>
      <th>Criterio</th>
      <th>Idea</th>
      <th>Razonamiento</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>h1</td>
      <td>Valor del ítem (↓)</td>
      <td>Ítems más valiosos primero</td>
      <td>Maximiza el beneficio absoluto</td>
    </tr>
    <tr>
      <td>h2</td>
      <td>Peso del ítem (↑)</td>
      <td>Ítems más ligeros primero</td>
      <td>Maximiza el número de ítems</td>
    </tr>
    <tr>
      <td>h3</td>
      <td>Valor / Peso (↓)</td>
      <td>Ítems más eficientes</td>
      <td>Maximiza la eficiencia valor–capacidad</td>
    </tr>
  </tbody>
</table>

<p>Para tamaños pequeños como $50$, algoritmo <em>Greedy</em> con la primera heurística y una restricción generosa del $40\%$ sobre el total de número de objetos, obtenemos resultados muy decentes:</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/algoritmos-geneticos/fitness_comparison_50_h1_40.png" alt="Convergencia de Greedy vs GA + Soft vs GA + Hard - Tamaño 50, restricción 40%" width="500" class="center" />
  <figcaption class="center">Convergencia de Greedy vs GA + Soft vs GA + Hard - Tamaño 50, restricción 40%</figcaption>
</figure>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>=== SOFT CONSTRAINTS ===
Best fitness score: 25.419778639697903
Total weight: 19.959887918754212
Total value: 25.419778639697903
Max capacity: 20

=== HARD CONSTRAINTS ===
Best fitness score: 25.419778639697903
Total weight: 19.959887918754212
Total value: 25.419778639697903
Max capacity: 20

=== GREEDY ===
Best fitness score: 25.367928277332897
Total weight: 19.93102578451347
Total value: 25.367928277332897
Max capacity: 20
</code></pre></div></div>

<p>Todos los algoritmos muestran buenas soluciones, siendo los <strong>GAs</strong> ligeramente superiores. Aun así, los tres obtienen soluciones muy buenas. Las dos funciones de <em>fitness</em> funcionan igual de bien. También se observa que <em>Greedy</em> es mucho más rápido, ya que ha tardado en converger menos de $50$ iteraciones, mientras que los genéticos han necesitado más de $100$ para igualar el <em>score</em>. Aunque es algo obvio, el <em>Greedy</em> no realiza exploración, solo explota una heurística de forma voraz.</p>

<p>Si probamos a cambiar la restricción y hacerla más complicada (esta vez no se podrá superar el $5\%$ del total en peso) veremos algunos cambios en los resultados:</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/algoritmos-geneticos/fitness_comparison_50_h1_5.png" alt="Convergencia de Greedy H1 vs GA + Soft vs GA + Hard - Tamaño 50, restricción 5%" width="500" class="center" />
  <figcaption class="center">Convergencia de Greedy H1 vs GA + Soft vs GA + Hard - Tamaño 50, restricción 5%</figcaption>
</figure>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>=== SOFT CONSTRAINTS ===
Best fitness score: 6.690651548303056
Total weight: 3.7789294493745977
Total value: 9.54957977253405
Max capacity: 2

=== HARD CONSTRAINTS ===
Best fitness score: 0.0
Total weight: 12.428228685377153
Total value: 13.08190249886287
Max capacity: 2

=== GREEDY ===
Best fitness score: 3.720164332689731
Total weight: 1.9952584283072372
Total value: 3.720164332689731
Max capacity: 2
</code></pre></div></div>

<p>Estos resultados ya son más interesantes. El algoritmo genético es igual en las dos comparaciones, pero la forma de evaluar es totalmente distinta. Con penalizaciones suaves o relativas, el algoritmo ha sido capaz de evaluar correctamente soluciones que eran a priori malas y las ha explorado y explotado inteligentemente obteniendo una solución final. En cambio las evaluaciones duras han destrozado la convergencia del genético y ha devuelto una solución sin refinar. De todas formas, el otro método no ha sido capaz de cumplir las restricciones impuestas, pasándose por $1.7$. Depende del contexto del problema, y esto es algo a evaluar dependiendo de las necesidades, esto podrá ser factible o inadmisible. La solución del <em>Greedy</em>, pese a no ser muy buena, cumple a rajatabla con el peso máximo permitido.</p>

<p>Probemos ahora con un tamaño más desafiante, un total de $200$ objetos y solo un $10\%$ de capacidad sobre el total permitido en la mochila:</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/algoritmos-geneticos/fitness_comparison_200_h1_10.png" alt="Convergencia de Greedy H1 vs GA + Soft vs GA + Hard - Tamaño 200, restricción 10%" width="500" class="center" />
  <figcaption class="center">Convergencia de Greedy H1 vs GA + Soft vs GA + Hard - Tamaño 200, restricción 10%</figcaption>
</figure>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>=== SOFT CONSTRAINTS ===
Best fitness score: 49.986377238685016
Total weight: 19.824506933869955
Total value: 49.986377238685016
Max capacity: 20

=== HARD CONSTRAINTS ===
Best fitness score: 0.0
Total weight: 56.058575444418665
Total value: 48.303356578426225
Max capacity: 20

=== GREEDY ===
Best fitness score: 40.175288587973824
Total weight: 19.997759251464615
Total value: 40.175288587973824
Max capacity: 20
</code></pre></div></div>

<p>La penalización dura sigue sin converger, mientras que el <strong>GA</strong> con <em>fitness</em> suave da los mejores resultados, con una convergencia suave y sin llegar a violar las restricciones impuestas. Los genéticos parecen una muy buena opción hasta ahora, pero probemos a cambiar una variable. Esta vez vamos a probar otra heurística en el algoritmo <em>Greedy</em>. La heurística número $3$, que ordena los objetos por el valor en relación al peso:</p>

<!-- _includes/image.html -->
<figure>
  <img src="/assets/images/algoritmos-geneticos/fitness_comparison_200_h3_10.png" alt="Convergencia de Greedy H3 vs GA + Soft vs GA + Hard - Tamaño 200, restricción 10%" width="500" class="center" />
  <figcaption class="center">Convergencia de Greedy H3 vs GA + Soft vs GA + Hard - Tamaño 200, restricción 10%</figcaption>
</figure>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>=== SOFT CONSTRAINTS ===
Best fitness score: 43.462952020478
Total weight: 19.97950402605357
Total value: 43.462952020478
Max capacity: 20

=== HARD CONSTRAINTS ===
Best fitness score: 0.0
Total weight: 51.83288833879617
Total value: 46.00902743825782
Max capacity: 20

=== GREEDY ===
Best fitness score: 46.28502186266642
Total weight: 19.94989976262729
Total value: 46.28502186266642
Max capacity: 20
</code></pre></div></div>

<p>El <em>Greedy</em> con la tercera heurística es no solo el más rápido, sino que es mejor, además de tener la garantía de no violar la restricción. Estos resultados ponen de manifiesto una idea clásica en optimización: una heurística sencilla, bien alineada con la estructura del problema, puede superar con facilidad a métodos mucho más complejos. En este caso, una ordenación simple basada en la eficiencia valor–peso permite al algoritmo <em>Greedy</em> encontrar soluciones de alta calidad de forma extremadamente rápida y sin violar las restricciones, incluso en escenarios más exigentes.</p>

<p>No obstante, esta ventaja depende fuertemente de la calidad de la heurística elegida. Cuando dicha heurística no captura adecuadamente la dinámica del problema, el rendimiento del enfoque voraz se degrada rápidamente. En contraste, los algoritmos genéticos muestran un comportamiento mucho más estable a lo largo de todos los escenarios analizados (sin ser esto un estudio riguroso ni de lejos). Con un diseño adecuado de la función de <em>fitness</em>, los <strong>GAs</strong> son capaces de explorar y explotar el espacio de soluciones de forma robusta, adaptándose a distintas restricciones y tamaños del problema sin colapsar.</p>

<h2 id="otras-codificaciones">Otras codificaciones</h2>

<p>Finalmente, quería explicar que los algoritmos genéticos son en origen binarios, pero también aceptan otras codificaciones, como la continua, es decir, valores reales. Esto requiere de una adaptación sobre los operadores ya explicados para poder manejar este tipo de representación, pero la naturaleza del algoritmo es la misma. Este tipo de codificación abre la puerta a resolver problemas de optimización continua. He preparado una versión continua del <strong>GA</strong>, con ayuda de <em>ChatGPT</em> para crear unas animaciones, de forma que quede claro visualmente cómo converge la población hacia el máximo de la función definida. Las funciones que va a optimizar son las siguientes:</p>
<ol>
  <li>
    <p><strong>Sphere</strong></p>

\[f(x,y) = -\left(x^2 + y^2\right)\]
  </li>
  <li>
    <p><strong>Rastrigin</strong></p>

\[f(x,y) = -\left[ 2A + \left(x^2 - A\cos(2\pi x)\right) + \left(y^2 - A\cos(2\pi y)\right) \right],
\quad A = 10\]
  </li>
  <li>
    <p><strong>Ackley</strong></p>

\[f(x,y) = -\left[
 -20\, e^{-0.2\sqrt{0.5(x^2 + y^2)}}
 - e^{0.5(\cos(2\pi x) + \cos(2\pi y))}
 + e + 20
 \right]\]
  </li>
  <li>
    <p><strong>Booth</strong></p>

\[f(x,y) = -\left[(x + 2y - 7)^2 + (2x + y - 5)^2\right]\]
  </li>
</ol>

<!-- _includes/image_grid.html -->
<figure class="image-grid">
  <div class="image-row">
    
    
      <img src="/assets/images/algoritmos-geneticos/ga_ackley.gif" alt="Evolución del algoritmo genético en funciones benchmark" class="grid-image" />


      <img src="/assets/images/algoritmos-geneticos/ga_booth.gif" alt="Evolución del algoritmo genético en funciones benchmark" class="grid-image" />
      
      
        </div><div class="image-row">
      
    
      <img src="/assets/images/algoritmos-geneticos/ga_rastrigin.gif" alt="Evolución del algoritmo genético en funciones benchmark" class="grid-image" />


      <img src="/assets/images/algoritmos-geneticos/ga_sphere.gif" alt="Evolución del algoritmo genético en funciones benchmark" class="grid-image" />


  </div>
  <figcaption class="center">Evolución del algoritmo genético en funciones benchmark</figcaption>
</figure>

<p>He de ser sincero, solo quería añadir estas animaciones porque molan.</p>

<p>Los algoritmos genéticos son uno de los muchos métodos metaheurísticos que existen. Desde luego no son los mejores, pero les tengo cariño y su diseño es inteligente a la par que sencillo. Es divertido programar <strong>GAs</strong>. Además, investigar en el camino las distintas decisiones de diseño que se pueden tomar, es enriquecedor.</p>]]></content><author><name></name></author><category term="algoritmos genéticos" /><category term="optimización" /><category term="metaheurísticas" /><category term="machine learning" /><category term="python" /><summary type="html"><![CDATA[Guía completa sobre algoritmos genéticos y optimización: fundamentos teóricos, función fitness, problema de la mochila, comparativa con greedy y ejemplos prácticos en Python.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://migue8gl.dev/assets/images/algoritmos-geneticos/ga_ackley.gif" /><media:content medium="image" url="https://migue8gl.dev/assets/images/algoritmos-geneticos/ga_ackley.gif" xmlns:media="http://search.yahoo.com/mrss/" /></entry></feed>