Contexto
No sé vosotros, pero a mí no me ha gustado nunca la estadística, al menos en mis años de estudiante. En el colegio me enseñaron la parte más básica donde se resolvían problemas del estilo frecuentista, probabilidades básicas, probabilidades conjuntas, disjuntas etc. Pero en la universidad, quizá fuese mala suerte, lo de tener tablas de p-valores para las distintas distribuciones, fórmulas de usar y tirar sin tener que entenderlas… Todo eso me pudo. Si no entiendo la base de lo que estoy haciendo y por qué lo estoy haciendo, pierdo el interés. Pero por desgracia, de eso trataba la asignatura, de aprender una serie de reglas que se tienen que usar en un orden y en unos problemas concretos. Un A, B y C.
Creo que esta forma de enseñar la estadística y probabilidad no es algo que haya experimentado solo yo. Leyendo el maravilloso libro de el arte de la estadística, el propio David Spiegelhalter lo menciona: “Generations of students have suffered through dry statistics courses based on learning a set of techniques to be applied in different situations…“. La lectura de este libro me ha hecho refrescar muchos conceptos y digerir otros tantos de una forma que ninguna asignatura haya conseguido en mí. La verdad es que, en realidad, muchos de ellos son muy sencillos, por lo que recomiendo leer este libro a cualquiera que quiera reconciliarse con la estadística.
Dicho esto, creo que me es conveniente escribir un poco sobre lo aprendido, concretamente sobre p-valores, contraste de hipótesis y peligros de usar estas herramientas mal (es mucho más fácil autosabotearse de lo que parece).
¿Qué es un contraste de hipótesis?
Todos los artículos científicos usan contraste de hipótesis. Cuando algún estudio clama haber demostrado algo, como que la radiación solar provoca cáncer, o que el contenido de scroll infinito degrada la capacidad cognitiva o cualquier cosa que tu cuñado dictamine como verdad absoluta porque lo demuestra un “estudio”. Los descubrimientos científicos se basan en este tipo de herramientas para validar sus hallazgos. Una hipótesis es una explicación propuesta para un fenómeno concreto. No es la verdad absoluta, es provisional. Cuando se trabaja para contrastar hipótesis se fabrica una hipótesis nula sobre la que trabajar de forma provisional hasta encontrar evidencia suficiente contra ella. Algunos ejemplos podrían ser:
- La radiación solar no aumenta el riesgo de cáncer.
- El medicamento no es más efectivo que el tratamiento actual.
- Los niveles de miostatina no afectan a la masa muscular de una persona.
No sé si os habéis dado cuenta del patrón, pero la hipótesis nula siempre niega el cambio o el efecto de aquello que estamos estudiando. La hipótesis nula nunca es probada, pero puede ser refutada durante el proceso de experimentación.
Los famosos p-valores
Pongamos un ejemplo primero, para entrar en situación. Vamos a imaginar que tenemos dos monedas. Lo normal es que ambas monedas, al pedir cara o cruz, tengan una probabilidad del $50\%$ para que salga cara y para que salga cruz, es decir, ambas deberían salir igual número de veces al repetir el experimento. Bien, pues una de esas monedas está trucada y tiene un $60\%$ para cara y solo un $40\%$ para cruz. Si lanzásemos, digamos, unas $200$ veces cada moneda, deberíamos ver alguna diferencia, ¿no? En Python podríamos modelarlo de la siguiente manera:
sample_size = 200

tricked_coin = np.random.choice(
    [0, 1],
    size=sample_size,
    p=[0.40, 0.60]
)

normal_coin = np.random.choice(
    [0, 1],
    size=sample_size,
    p=[0.5, 0.5]
)
En el caso de dos monedas normales, si contamos cuántas veces ha salido cara en cada muestra y restamos ambos conteos entre sí, debería ser un número muy cercano a cero, pues cada lado puede salir un $50\%$ de las veces en cada moneda. Puede ser que esa diferencia no sea cero, por puro azar. Si repetimos el experimento $1000$ veces y hacemos la media de las diferencias, ahora sí, debería ser $0$. En algunas ocasiones de esas $1000$ habrá salido $4$, o $2$ o incluso $-3$ (que haya salido cara más veces en la segunda moneda que en la primera), pero la media es $0$.
Volvamos al caso en el que tenemos una moneda normal y otra trucada. Si repetimos este experimento con estas monedas, al tener la moneda trucada más posibilidades de salir cara, la media va a estar desviada de cero. Pongamos que la diferencia observada es:
\[diferencia\_observada=caras\_trucada-caras\_normal\]La media de las diferencias de los experimentos va a salir desviada con respecto a cómo saldría en la situación normal, donde estaría centrada en $0$. Ejecutemos el siguiente código de Python simulando los experimentos:
sample_size = 200
num_experiments = 1000

tricked_coin = np.random.choice([0, 1], size=sample_size, p=[0.4, 0.6])
normal_coin = np.random.choice([0, 1], size=sample_size, p=[0.5, 0.5])

tricked_heads = tricked_coin.sum()
normal_heads = normal_coin.sum()

observed_difference = tricked_heads - normal_heads

sim_coin_a = np.random.choice([0, 1], size=(num_experiments, sample_size), p=[0.5, 0.5])
sim_coin_b = np.random.choice([0, 1], size=(num_experiments, sample_size), p=[0.5, 0.5])

differences = sim_coin_a.sum(axis=1) - sim_coin_b.sum(axis=1)

sns.histplot(differences, bins=20)

plt.axvline(
    observed_difference,
    linestyle="--",
    c="orange",
    label=f"Diferencia observada = {observed_difference}",
)

plt.xlabel("Diferencia de caras")
plt.ylabel("Frecuencia")
plt.legend()
plt.show()
La función np.random.choice([0, 1]) produce la elección del valor $0$ o $1$ (cara o cruz) con igual probabilidad por defecto. Para trucar la moneda, añadimos las probabilidades p=[0.4, 0.6]. Lo que el código hace es simular el lanzamiento de las dos monedas $200$ veces para luego hacer el conteo de las caras. Ya tenemos nuestra muestra. Ahora, debemos simular la distribución bajo la hipótesis nula, la distribución que niega los efectos. Sencillamente, el caso normal es que no haya ningún truco, por lo que los lanzamientos de ambas monedas tendrán una probabilidad de $0.5$ para cara o cruz. Simulamos esto generando num_experiments pares de monedas (en este caso, $1000$), cada una con sample_size lanzamientos, ambas con p=[0.5, 0.5]. Para cada uno de esos $1000$ experimentos simulados, contamos las caras de cada moneda y calculamos la diferencia entre ambas. El resultado es differences: un array con $1000$ diferencias, todas generadas bajo el supuesto de que no hay truco alguno.
Esta distribución es justo lo que necesitamos, ya que representa cómo de grande podría ser la diferencia entre dos monedas por puro azar, incluso siendo ambas justas. ¿Qué pasará cuando comparemos esos resultados con la muestra que contiene una moneda trucada? Pues vamos a graficarlo.
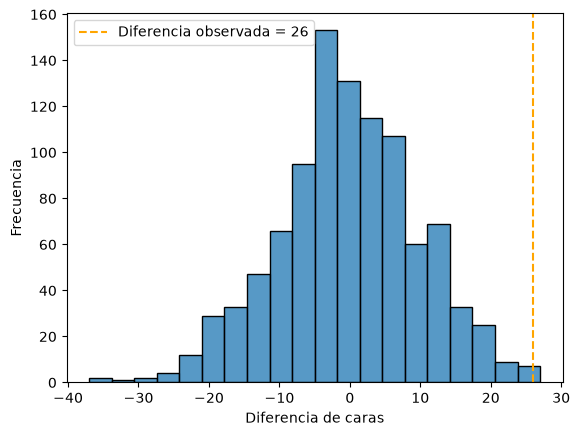
Podemos observar que claramente hay una diferencia frente al caso normal, a la hipótesis nula, pero, ¿es suficientemente diferente? Podemos saber que el valor observado de $26$ está muy a la derecha en la cola de la distribución, por lo que es un valor raro. ¿Cuál es la probabilidad de obtener ese valor en circunstancias normales? Esa es la pregunta clave. Si la hipótesis nula es real, la hipótesis que defiende que ambas monedas son normales y que tienen las mismas probabilidades para cara y cruz, si eso fuese así, entonces obtener una diferencia de $26$ caras es raro de narices. Concretamente, bajo los supuestos de la hipótesis nula, solo debería ocurrir $1$ de cada $100$ veces.
Esa probabilidad observada es exactamente nuestro p-valor. El p-valor se define como la probabilidad de obtener un resultado en nuestro estadístico al menos igual de extremo que el que hemos conseguido, si la hipótesis nula fuera cierta. Esta probabilidad se podría calcular en este caso como el área que deja a la derecha:
p_value = np.mean(differences >= observed_difference)
Por supuesto, en este caso estamos calculando el p-valor de una cola, ya que solo mide el área de la derecha. Calcular también el área de la izquierda implicaría tener en cuenta valores extremos en ambos sentidos. A este tipo de test con las dos colas se le conoce como two-sided test o two-tailed test. Pero como en este caso la moneda está trucada para favorecer caras, solo nos interesa una diferencia positiva.
Entonces, ¿qué se conoce como evidencia estadística?
Normalmente, queremos rechazar la hipótesis nula con un p-valor muy bajo. El estándar está en usar $0.05$ o $0.01$ como mínima probabilidad a obtener, pero la elección de estos números concretos es más arbitraria que otra cosa. Por tanto, existe evidencia estadística cuando rechazamos la hipótesis nula porque el p-valor observado es más pequeño que el límite $\alpha$ establecido, es decir, la observación es tan extrema, que bajo las condiciones de que la hipótesis nula sea real, esta habría ocurrido con una probabilidad de p-valor. Pero, ¿de verdad es suficiente para establecer lo observado en un experimento como una verdad? Muchos son los que indican los problemas de los p-valores, de hecho, se han desarrollado otro tipo de herramientas como los e-valores, pero todavía no tienen suficiente acogida en las metodologías de investigación ya establecidas. Pese a ello, muchas veces el problema no viene por parte de la herramienta, sino de la persona que la usa. No son pocos los científicos poco honestos (o poco lúcidos) quienes repiten experimentos hasta encontrar un p-valor que se ajuste a lo que buscan. Esta práctica entraría dentro de lo que se conoce como p-hacking.
Descubriendo evidencia falsa
Pongamos de nuevo el experimento de lanzar monedas al aire para contar cuántas veces sale cara en cada una de ellas, pero esta vez las dos monedas son justas. De todas formas, vamos a plantear la hipótesis nula de que hay una que está trucada, por lo que la diferencia entre la media de veces que sale cara en una moneda y la media de veces que sale en la otra debería desviarse mucho de cero. Vamos a poner también la condición de rechazar esta hipótesis si obtenemos un p-valor igual o más extremo que $0.05$. Se repetirá el experimento cien veces, a ver qué pasa. El código en Python es el siguiente:
num_experiments = 100
sample_size = 1000
alpha = 0.05

p_values = []

for _ in range(num_experiments):
    group_a = np.random.choice([0, 1], size=sample_size)
    group_b = np.random.choice([0, 1], size=sample_size)

    _, p = stats.ttest_ind(group_a, group_b)
    p_values.append(p)

p_values = np.array(p_values)

sns.histplot(p_values, bins=20)
plt.axvline(alpha, color='red', linestyle='--', label=f"α = {alpha}")
plt.xlabel('p-valor')
plt.title(f'Falsos positivos: {(p_values < alpha).mean():.1%} (esperado ~{alpha*100}%)')
plt.legend()
plt.show()
Y obtenemos lo siguiente:
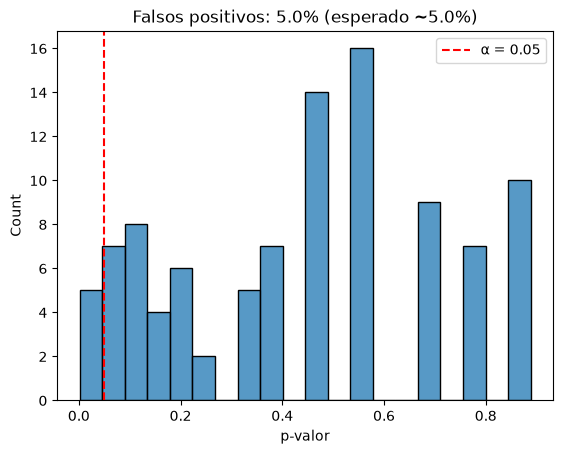
Lo que obtenemos es hasta $5$ falsos positivos (un $5\%$), por lo que hemos descubierto $5$ casos en los que parece haber una diferencia entre las dos monedas. Obviamente esto no es así, hemos forzado la máquina para descubrir una evidencia que es falsa. Si ponemos un $5\%$ como límite, el otro $95\%$ de las veces se cumplirá lo esperado según los supuestos de la hipótesis nula, pero esta probabilidad disminuye con cada experimento. Supongamos que cada vez que repetimos el test, la probabilidad de no obtener un falso positivo es del $95\%$ ($0.95$) pues nuestro $\alpha$=0.05$. Si repetimos el experimento varias veces, la probabilidad de que todas las veces sean correctas (sin falsos positivos) va disminuyendo:
- Experimento 1: $0.95$ → probabilidad de que no haya falso positivo: $95\%$
- Experimento 2: $0.95 \times 0.95 = 0.9025$ → $90.25\%$
- Experimento 3: $0.95 \times 0.95 \times 0.95 = 0.857375$ → $85.74\%$
- Experimento 4: $0.95^4 = 0.81450625$ → $81.45\%$
- Experimento 5: $0.95^5 = 0.7737809375$ → $77.38\%$
- Experimento 6: $0.95^6 = 0.735191890625$ → $73.52\%$
- Experimento 7: $0.95^7 = 0.69843229609375$ → $69.84\%$
- Experimento 8: $0.95^8 \approx 0.6635106812890625$ → $66.35\%$
- Experimento 9: $0.95^9 \approx 0.630335147…$ → $63.03\%$
- Experimento 10: $0.95^{10} \approx 0.598736939…$ → $59.87\%$
- Experimento 15: $0.95^{15} \approx 0.463291…$ → $46.33\%$
- Experimento 20: $0.95^{20} \approx 0.358486…$ → $35.85\%$
- Experimento 30: $0.95^{30} \approx 0.214639…$ → $21.46\%$
- Experimento 50: $0.95^{50} \approx 0.076945…$ → $7.69\%$
Aunque cada experimento individual tiene solo un $5\%$ de probabilidad de dar un falso positivo, si repetimos el proceso suficientes veces la probabilidad de encontrar alguna “evidencia” espuria se dispara. Con tan solo $50$ intentos, ya tenemos más de un $92\%$ de probabilidad de toparnos con al menos un resultado “significativo” que en realidad es pura casualidad. Pues esto muchas veces se hace y se publican los resultados en artículos científicos.
Cómo paliar los efectos de múltiples test
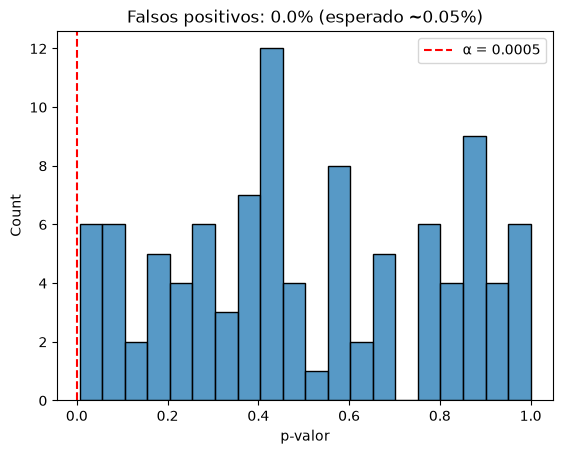
Hacer muchos test per se no es malo, muchas veces el protocolo lo requiere. Por ello existen las llamadas correcciones, métodos para paliar estos efectos resultantes de testear múltiples veces. La más sencilla y fácil de implementar es el método de Bonferroni. Si el umbral es $\alpha$ y se hacen $n$ test, entonces la corrección es:
\[\alpha_B=\frac{\alpha}{n}\]De esta forma, se disminuye $\alpha$ de forma proporcional al número de test que se hacen. Si repetimos los experimentos previos con la corrección obtenemos:
La estadística no es como nos la enseñaron
Tratar de enseñar esta rama del conocimiento como si se tratase de una caja de herramientas no tiene sentido alguno y no desarrolla una intuición científica ni crítica, es normal que luego salgan tantos artículos científicos basura. Pero detrás de todo lo que nos han enseñado hay un porqué, el cómo vendrá luego, el porqué es más importante. Recursos como el libro de Spiegelhalter son una maravilla y os animo de corazón a intentar mejorar vuestro entendimiento estadístico. Solo así seremos menos influenciables y más objetivos, pues la estadística es una forma precisa de ver el mundo, pero también muy fácil de manipular.