Privacidad y seguridad
Este artículo va a ser el primero de una mini serie, donde voy a explicar y a programar sencillos scripts en Python para entender cómo funciona este mundo de la privacidad en el machine learning. Es un tema que, si os soy sincero, no sabía que existía hace un año. Lo descubrí mientras investigaba artículos de referencia para mi trabajo de fin de máster (estudio de métodos OOD). En concreto, estaba buscando algún método que fuese capaz de mejorar el prior en que se basan los modelos VAE (Variational Autoencoders), y de esa forma, poder mejorar el espacio latente para detectar mejor los datos fuera de distribución. Sé que suena a chino, ya explicaré mejor en qué consisten los VAE. El caso es que encontré este paper, que poco tiene que ver con detección. Aquí fue cuando conocí este nicho que es la privacidad en machine learning (a partir de ahora lo acortaré a ML).
A grandes rasgos, existen métodos por los cuales es posible extraer datos sensibles de un modelo. No solo eso, también se puede “envenenar” ese modelo de forma que deteriore sus predicciones. La cantidad de tipos de ataques que se pueden realizar es bastante amplia, por ello, lo trataré en otros capítulos de esta mini serie.
Datos sintéticos
Seguramente hayáis oído hablar de datos sintéticos en el ámbito de la IA moderna. Simulaciones de conversaciones con ChatGPT, imágenes generadas con algún modelo de difusión, simulaciones de entornos de conducción, etc. Todo ello con la finalidad de suplir la necesidad voraz de datos que hoy en día acucia a las grandes empresas de IA. Pues vamos a hacer algo parecido pero a menor escala, con datos tabulares, algo más cutre.
Antes he mencionado ataques capaces de extraer datos sensibles de usuarios a partir de un modelo de ML. El cómo es tema de un futuro capítulo, el porqué es obvio, a día de hoy cualquier dato de cualquier persona en conjunto con algo más de información sirve a muchos delincuentes muy creativos para poder desarrollar ataques y estafas cada vez más enrevesados y eficaces. Imaginemos un modelo entrenado para detectar enfermedades a partir de historiales médicos. Un atacante podría utilizar determinadas técnicas para intentar averiguar qué información ha visto el modelo durante su entrenamiento o, incluso, si los datos de una persona concreta formaron tiene ciertas características. Esto último puede parecer una información menor, pero pensemos en un modelo entrenado exclusivamente con pacientes que padecen una determinada enfermedad. Si conseguimos demostrar que los datos de una persona concreta fueron utilizados para entrenarlo, acabamos de obtener una pista bastante clara sobre su estado de salud, sin necesidad de acceder directamente a su historial médico.
La solución más evidente es la de entrenar con datos sintéticos, datos de personas ficticias, pero que mantengan una distribución y cierto tipo de información similar a los datos originales. La creación de este tipo de dato no es cosa menor, dicho de otra manera, es cosa mayor ~ Rajoy. Para generar datos sintéticos de calidad se necesitan los datos originales y métodos suficientemente refinados. Es una constante lucha entre mejorar la calidad y no desvelar información de los datos originales, porque prácticamente no existe ningún método que sea totalmente infalible. Mejorar una métrica, seguramente empeore otra y por tanto hay que encontrar un equilibrio.
Hoy voy a explicar algunos de los métodos más sencillos para medir la calidad de los datos sintéticos. Uno para medir si los datos son robustos frente a un tipo de ataque concreto y otro para evaluar la similitud con los datos reales. A medida que avance esta serie, iré incorporando otros más elaborados usando métricas específicas y métodos avanzados.
Generación de datos sintéticos con un CVAE
Los ya mencionados Variational Autoencoders son un tipo de red neuronal capaz de aprender la distribución de los datos y utilizarla para generar nuevas muestras. A diferencia de un autoencoder tradicional, que transforma cada entrada $x$ en un único vector latente $z$, un VAE aprende una distribución:
\[q_\phi(z|x) = \mathcal{L}(\mu_\phi(x), \sigma_\phi(x)^2)\]De esta distribución se muestrea $z$, que posteriormente utiliza el decoder para reconstruir el dato:
\[z = \mu + \sigma\epsilon, \qquad \epsilon \sim \mathcal{N}(0,I)\]Durante el entrenamiento se busca que el dato reconstruido sea similar al original y, al mismo tiempo, que las distribuciones latentes se parezcan a una distribución normal. Por ello, la función de pérdida combina un término de reconstrucción (que los datos se parezcan a los originales) con la divergencia KL (digamos que es como una “"”distancia””” entre distribuciones):
\[\mathcal{L} = \mathcal{L}{reconstrucción} + D{KL}(q_\phi(z|x),||,p(z))\]Esta regularización hace que el espacio latente sea más continuo y permite muestrear nuevos puntos para generar datos. Aunque los modelos generativos actuales son mucho más complejos, los VAE siguen utilizándose como componentes de arquitecturas más grandes.
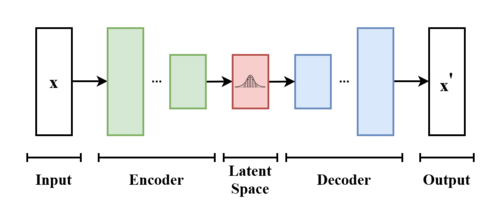
Con un modelo de este tipo, podríamos muestrear el espacio latente aprendido de forma aleatoria y reconstruir esas muestras. No son datos reales, pero deberían conservar características similares. Estos son nuestros datos sintéticos. Pero hay un problema. Si queremos usarlos para predecir algo, ¿cómo sabemos qué predecimos? Es decir, tenemos datos muy parecidos a los reales, pero no sabemos qué son. En en el conjunto original teníamos algún tipo de información extra, por ejemplo, si quisiéramos clasificar pacientes (tiene cáncer o no tiene cáncer), o clientes (de riesgo o seguros), deberíamos tener una etiqueta para poder entrenar un modelo de clasificación binario. Eso el VAE no lo ha aprendido y por tanto, solo tenemos un batiburrillo de puntos en el espacio.
Por fortuna, existe una variación capaz de aprender no solo la distribución de los datos, sino también la clase de estos. Los Conditional Variational Autoencoders o CVAE entienden también qué tipo de datos queremos generar. A partir de ahora vamos a trabajar con el conjunto de Iris, por lo que pongamos un ejemplo:
| Largo sépalo | Ancho sépalo | Largo pétalo | Ancho pétalo | Clase |
|---|---|---|---|---|
| 5.1 | 3.5 | 1.4 | 0.2 | setosa |
| 4.9 | 3.0 | 1.4 | 0.2 | setosa |
| 6.4 | 3.2 | 4.5 | 1.5 | versicolor |
| 5.9 | 3.0 | 4.2 | 1.5 | versicolor |
| 6.3 | 3.3 | 6.0 | 2.5 | virginica |
| 5.8 | 2.7 | 5.1 | 1.9 | virginica |
Cada flor está descrita por cuatro características numéricas y pertenece a una de tres clases. El CVAE puede aprender la distribución de estas características condicionada a la clase. Es decir, en lugar de aprender únicamente $p(x)$, buscamos aprender algo como:
\[p(x|c)\]donde $x$ representa las características de la flor y $c$ su clase.
Para que la red pueda utilizar esta información, primero transformamos la clase mediante one-hot encoding. Por ejemplo:
\[\text{setosa} = [1,0,0]\] \[\text{versicolor} = [0,1,0]\] \[\text{virginica} = [0,0,1]\]Esta representación se introduce en el encoder junto con las características de la flor. De esta forma, el encoder no recibe únicamente $x$, sino también la clase $c$:
\[q_\phi(z|x,c)\]El decoder recibe igualmente esta información para generar una muestra perteneciente a la clase indicada:
\[p_\theta(x|z,c)\]Por ejemplo, podríamos proporcionar al decoder un vector latente $z$ y la condición $c=[0,0,1]$. El modelo intentará generar entonces las características de una flor virginica. Así podemos generar nuevas muestras no solo parecidas a los datos originales, sino pertenecientes a la clase que nosotros indiquemos.
El código del CVAE es el siguiente:
class CVAE(nn.Module):
    def __init__(
        self,
        input_dim: int,
        hidden_dim: int,
        latent_dim: int,
        num_classes: int,
    ):
        super().__init__()
        self.encoder = nn.Sequential(
            nn.Linear(in_features=input_dim + num_classes, out_features=hidden_dim),
            nn.ReLU(),
        )

        self.mu = nn.Linear(in_features=hidden_dim, out_features=latent_dim)
        self.logvar = nn.Linear(in_features=hidden_dim, out_features=latent_dim)

        self.decoder = nn.Sequential(
            nn.Linear(in_features=latent_dim + num_classes, out_features=hidden_dim),
            nn.ReLU(),
            nn.Linear(in_features=hidden_dim, out_features=input_dim),
        )

    def encode(self, x: Tensor, y: Tensor):
        h = self.encoder(torch.cat([x, y], dim=1))
        return self.mu(h), self.logvar(h)

    def decode(self, z: Tensor, y: Tensor):
        return self.decoder(torch.cat([z, y], dim=1))

    def forward(self, x: Tensor, y: Tensor):
        mu, logvar = self.encode(x, y)

        std = torch.exp(0.5 * logvar)
        z = mu + std * torch.randn_like(std)

        x_hat = self.decode(z, y)

        return x_hat, mu, logvar
Para generar muestras sintéticas solo necesitamos el decoder. Muestreamos aleatoriamente un vector $z$ del espacio latente siguiendo una distribución gaussiana y lo pasamos al decoder junto con la clase que queremos generar. El decoder transforma este vector en una nueva muestra con las características correspondientes a dicha clase:
def generate_synthetic_sample(
    model: torch.nn.Module,
    sample_size: int,
    latent_dim: int,
    num_classes: int,
) -> tuple[torch.Tensor, torch.Tensor]:
    size = sample_size // num_classes
    samples = []
    sample_labels = []

    with torch.inference_mode():
        for i in range(num_classes):
            z = torch.randn(size, latent_dim, device=DEVICE)
            labels = torch.full((size,), i, dtype=torch.long, device=DEVICE)
            y = F.one_hot(labels, num_classes=num_classes).float()

            X_synth = model.decode(z, y)
            samples.append(X_synth)
            sample_labels.append(labels)

    return torch.cat(samples), torch.cat(sample_labels)
Evaluación por potencia predictiva
Ahora ya tenemos un modelo capaz de generar datos de Iris de forma infinita, generar flores ficticias que nunca han sido registradas porque no existen. Pero, ¿realmente sirven estos datos artificiales para nuestro propósito de entrenar un predictor de especies de flores? Quiero recordar que los hemos generado con un propósito. Vamos a usarlos en vez de los originales, vaya a ser que un hacker del ML filtre importantísima información privada de las flores. En estos casos, existe un protocolo llamado train synthetic, test real. Vamos a ponerlo en práctica. Usaremos los datos sintéticos para entrenar un clasificador cualquiera, y si de verdad son buenos, cuando evaluemos el modelo en un conjunto de test real con datos que nunca ha visto, debería tener un buen rendimiento.
El protocolo es el siguiente: entrenamos dos modelos, uno con los datos de entrenamiento originales y otro con los datos sintéticos. Después, evaluamos ambos modelos sobre el mismo conjunto de test real. En este caso he probado con un modelo basado en logistic regression de scikit-learn, uno de los más básicos.
Además, vamos a utilizar una técnica llamada bootstrapping para estimar la variabilidad de los resultados. En lugar de quedarnos con una única medida de rendimiento, como el accuracy obtenido sobre el conjunto de test, generamos muchas muestras mediante muestreo con reemplazo (es decir, mismos valores pueden repetirse en el muestreo) a partir de los datos de test. Evaluamos el modelo sobre cada una de estas muestras y obtenemos así una distribución de los resultados.
Esto nos permite estimar un intervalo de confianza para las métricas y comprobar hasta qué punto las diferencias entre el modelo entrenado con datos reales y el entrenado con datos sintéticos son estables o pueden deberse a la variabilidad de la muestra de test.
La base estadística del método es que, bajo condiciones bastante generales, la distribución empírica obtenida mediante estas muestras con reemplazo proporciona una buena aproximación a la distribución muestral real que obtendríamos si pudiéramos repetir el experimento muchas veces. Por eso el bootstrap resulta especialmente útil cuando no conocemos o no queremos asumir una distribución paramétrica.
Para el público general $\rightarrow$ “Si pudiera repetir este experimento muchas veces con distintos conjuntos de test extraídos de la misma población, ¿cuánto cambiaría mi resultado?”
Los resultados son los siguientes:
| Métrica | R→R | S→R | Δ | IC 95% |
|---|---|---|---|---|
| Accuracy | 0.9333 | 0.8333 | −0.0986 | [−0.2000, 0.0000] |
| F1 Macro | 0.9333 | 0.8295 | −0.1068 | [−0.2306, 0.0000] |
| F1 Weighted | 0.9333 | 0.8295 | −0.1031 | [−0.2262, 0.0000] |
Como era de esperar, el clasificador entrenado con datos reales rinde mejor que el entrenado con sintéticos. En accuracy pasamos de $0.933$ a $0.833$. Aun así, el resultado del entrenamiento con los datos vomitados por el CVAE no es despreciable, ya que con una arquitectura muy simple y sin ajustar hiperparámetros, acierta $5$ de cada $6$ flores reales.
El bootstrapping apunta en la misma dirección. La diferencia ($\Delta S-R$) es negativa en las tres métricas, con IC al $95\%$ de aproximadamente $[-0.2, 0]$. Pero como el extremo superior toca el cero (los resultados son como mucho, iguales, y por ello la diferencia es cero), la evidencia es débil y no podemos descartar que la diferencia sea nula. Mejorar la arquitectura y los hiperparámetros probablemente reduzca la brecha.
¿Los datos sintéticos son realmente buenos?
Cuando queremos saber si los datos sintéticos son buenos, tenemos un amplio abanico de metodologías que nos proporcionan métricas muy interesantes para analizar. En este caso, vamos a probar con resemblance para ver lo buenos que son en similitud. Se trata de intentar distinguir si un dato es sintético o real, por lo que es una clasificación binaria. Para ello he utilizado un random forest como discriminador y he etiquetado cada muestra.
| precision | recall | f1-score | support | |
|---|---|---|---|---|
| 0.0 | 1.00 | 1.00 | 1.00 | 40 |
| 1.0 | 1.00 | 1.00 | 1.00 | 24 |
| accuracy | — | — | 1.00 | 64 |
| macro avg | 1.00 | 1.00 | 1.00 | 64 |
| weighted avg | 1.00 | 1.00 | 1.00 | 64 |
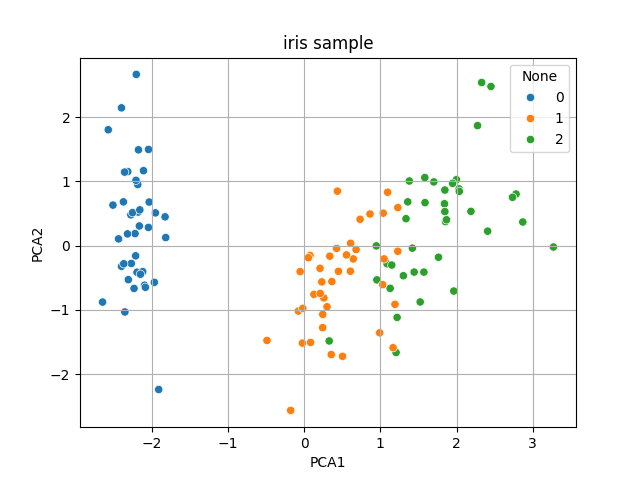
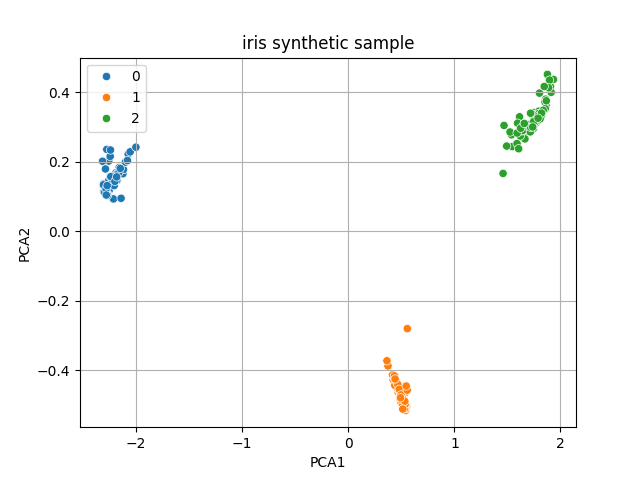
Los resultados son… ¡Una mierda! El discriminador es capaz de distinguir perfectamente entre los datos reales y los sintéticos. Desde el punto de vista de resemblance, esto indica que ambos conjuntos presentan diferencias claras que el random forest puede aprovechar para clasificarlos. De hecho, mirando las agrupaciones generadas en las imágenes anteriores, visualmente es bastante perceptible.
Sin embargo, este resultado no significa por sí mismo que los datos sintéticos sean inútiles ni que tengan una mala privacidad. Resemblance mide hasta qué punto los datos sintéticos se parecen a los reales, pero no mide directamente si existe riesgo de revelar información sobre los individuos utilizados durante el entrenamiento.
Que los datos sintéticos sean suficientemente útiles como para entrenar otro modelo no significa necesariamente que reproduzcan fielmente la distribución de los datos reales. Del mismo modo, conseguir que sean muy parecidos a los datos originales tampoco garantizaría que sean privados. Utilidad, similitud y privacidad son propiedades relacionadas, pero diferentes, y será necesario evaluarlas por separado.
¿Y qué pasa con la privacidad?
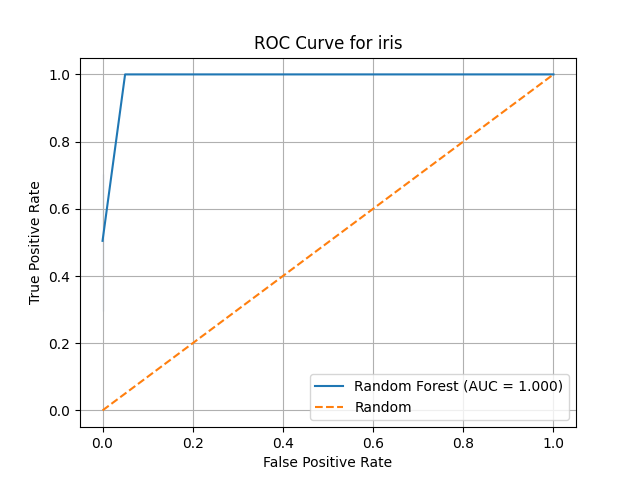
Para evaluar la privacidad necesitamos comprobar algo distinto, como por ejemplo, si es posible averiguar qué registros reales fueron utilizados para entrenar el CVAE. Para ello, realizamos un Membership Inference Attack, comparando los registros del conjunto de entrenamiento con los del conjunto de test. Para cada registro calculamos su distancia al dato sintético más cercano y utilizamos esta distancia como señal para intentar distinguir entre ambos grupos. Si el CVAE hubiera memorizado registros de entrenamiento, estos podrían quedar más cerca de los datos sintéticos generados que los registros que nunca vio.
La capacidad del ataque se mide mediante ROC-AUC, donde un valor cercano a $0.5$ indica que el ataque no consigue distinguirlos. En este experimento obtenemos un score de $0.461$, ¡buenas noticias por fin!
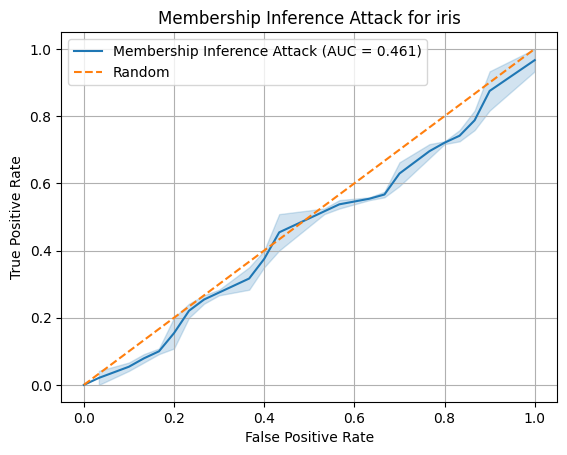
Esto, de nuevo, no significa que el CVAE sea completamente privado, sino únicamente que este ataque concreto no consigue extraer una señal clara de membership. Precisamente por eso, en los siguientes artículos veremos ataques y métricas más sofisticados para estudiar hasta qué punto los datos sintéticos pueden proteger realmente la información utilizada durante el entrenamiento y qué otras formas hay de generarlos.